クラウドクラブ10期でKubernetes CNIの勉強会に参加し、数か月かけてネットワークスタックを土台から見直す機会があった。運用していたクラスタがVXLANベースのFlannelを使っていたので、その構造は前回の記事に一度まとめてある。その記事の最後でCalicoとCiliumを比較しながら「CiliumはeBPFでnetfilterを迂回する」と一段落だけ書いて先へ進んでしまった。勉強会がCiliumの週に差しかかり、eBPFを公式ドキュメントから掘り下げることになったので、そのとき整理した内容を流してしまうのは惜しく、この記事として残す。あの一段落を展開した記事だと思ってもらえればいい。
出発点は、Ciliumクラスタで出くわした小さなパズルだ。Podの中からClusterIPへcurlを送りつつ、同じPodの eth0 でそのアドレスをキャプチャしてみた。
$ kubectl exec -it client -- sh
/ # curl -s http://10.96.45.10/ | head -1
<!DOCTYPE html>
/ # tcpdump -ni eth0 host 10.96.45.10
tcpdump: listening on eth0, link-type EN10MB (Ethernet)
^C
0 packets captured
curlは成功した。ところがそのPod自身のインターフェースにすらClusterIPが現れない。kube-proxy iptablesのクラスタなら、Podの eth0 にはClusterIPがそのまま載り、ホストの PREROUTING でDNATされて初めてPod IPに変わる。ノードでいつも見ていたチェーンを探しても見当たらない。
$ iptables -t nat -S | grep KUBE-SVC
$ conntrack -L | grep 10.96.45.10
conntrack v1.4.7: 0 flow entries have been shown.
DNATルールもなく、conntrackにもその接続がない。それでもパケットは届く。ip route、iptables、conntrack、tcpdump がどれも何も見えない状況だ。この記事では、このパケットがどこで処理されているのかを追いながらeBPFの構造を整理する。eBPFがカーネルのどの地点に割り込むのか、プログラムがどう載り、何で状態を共有するのか、そしてPodが数千個に増えたときにiptablesのチェーンとeBPFのマップがなぜ違う動きをするのかが中心だ。CiliumとCalicoは、その構造を実際にどう使っているかを示す例として脇に置く。
1章と2章の図はすべてebpf.io 公式ドキュメント「eBPFとは」から引用した(CC BY 4.0)。ドキュメントが図を並べた順序をそのまま追う。
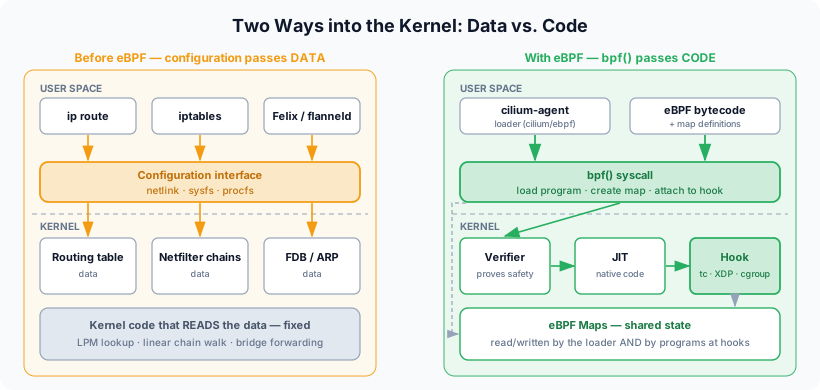
1. eBPF以前のカーネル — 設定しか渡せなかった
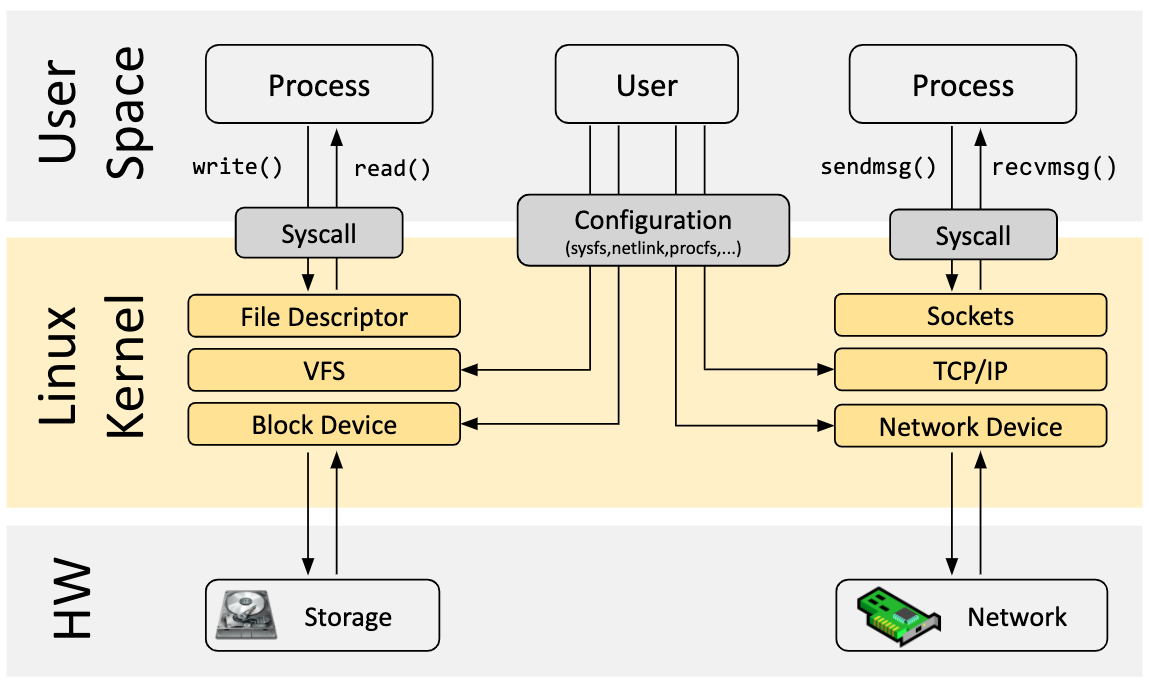
eBPFを抜いて描いたカーネルだ。プロセスはシステムコールでしかカーネルに入れず、パケットはSockets → TCP/IP → Network Deviceの順に下っていく。中央の Configuration(sysfs, netlink, procfs) の箱が、ユーザーがカーネルに影響を与えられる唯一の通路だ。
前回の記事で使った道具はすべてこの箱に入る。ip route、bridge fdb、iptables はnetlinkでカーネルのデータ構造にデータを入れるものだ。Flannelの flanneld も、CalicoのFelixとBIRDも、この通路でカーネルをプログラミングしていた。共通するのは、カーネルのコードはそのままで、そのコードが読むデータだけを変えるという点だ。ルーティングテーブルを引くコード、iptablesチェーンを上から下へなめるコードは、カーネルの中に固定されている。
この構造でカーネルの動作そのものを変えたければ、選択肢は二つしかない。カーネルソースを直して再ビルドするか、カーネルモジュールを載せるかだ。前者はディストリビューションのカーネルを使う環境では現実的でなく、後者はモジュール一つのバグがカーネル全体を止めうる。ネットワークスタックの特定の地点に「このパケットはこう処理しろ」というロジックを入れたいのに、その場所にデータ以外のものを安全に入れる方法がなかった。
eBPFはここに三つ目の選択肢を加える。データではなくコードを渡す通路だ。
2. eBPF — コードを渡す通路
設定インターフェースがカーネルのデータ構造に値を書き込む通路だったなら、eBPFはカーネルの決められた地点に小さなプログラムを取り付ける通路だ。そのプログラムがどんな形をしていて、どんな関門を経てカーネルに入るのかを順に見ていく。
2.1 フック — カーネルの要所ごとにプログラムを取り付ける場所
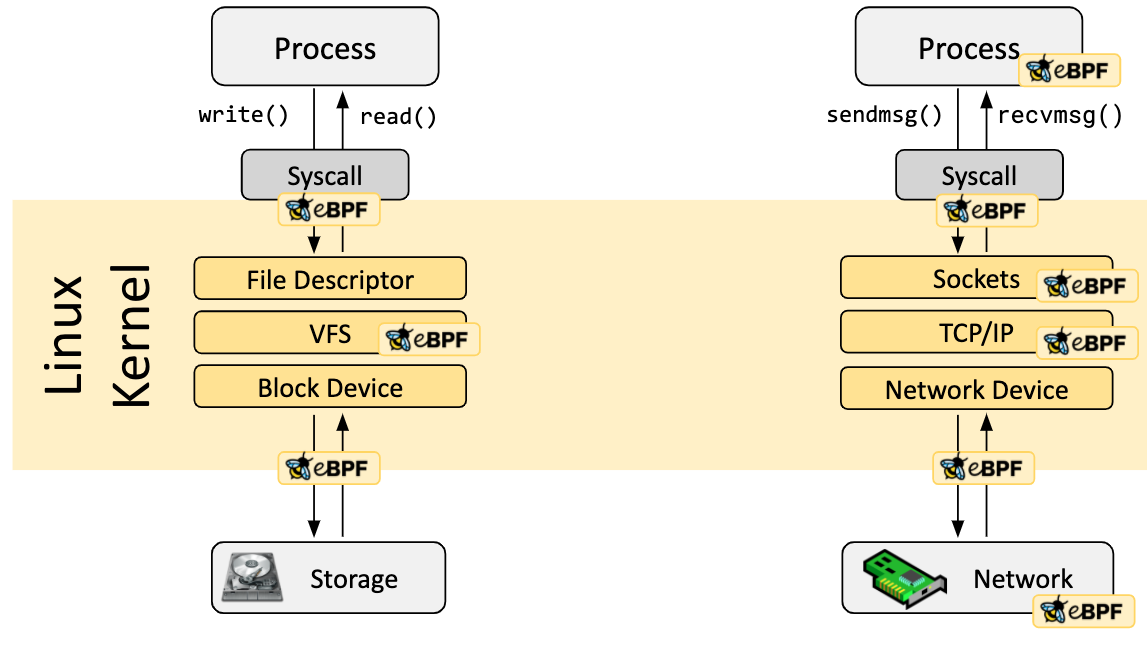
1章と同じ図にeBPFのアイコンが付いた。アイコン一つがフック(hook)一つだ。eBPFプログラムはどこでも実行されるわけではなく、カーネルがあらかじめ決めたこのフックにしか付かない。システムコールの入口、ソケット、TCP/IP、ネットワークデバイス、NICまで。左側のファイル経路にあるアイコンはトレース・セキュリティツールの領域で、この記事の関心は右の列にある。
| 図のアイコン | カーネルのフック | Ciliumでの用途 |
|---|---|---|
| 左の列(File, Storage) | kprobe, tracepoint, LSM | トレース・セキュリティツール(bpftrace, bcc, Tetragon)の領域 |
| Syscallの横 | cgroupソケットフック(connect, sendmsg, getpeername) | Service処理(ソケットLB) |
| TCP/IP | tc(traffic control)ingress / egress | Podトラフィック全部。ポリシー、転送、カプセル化 |
| Network Device | XDP(eXpress Data Path) | NodePortの高速化 |
これらのフックがNetfilterの五つのフックとどう並ぶかは、3章で別に見る。
2.2 イベントがプログラムを起こす
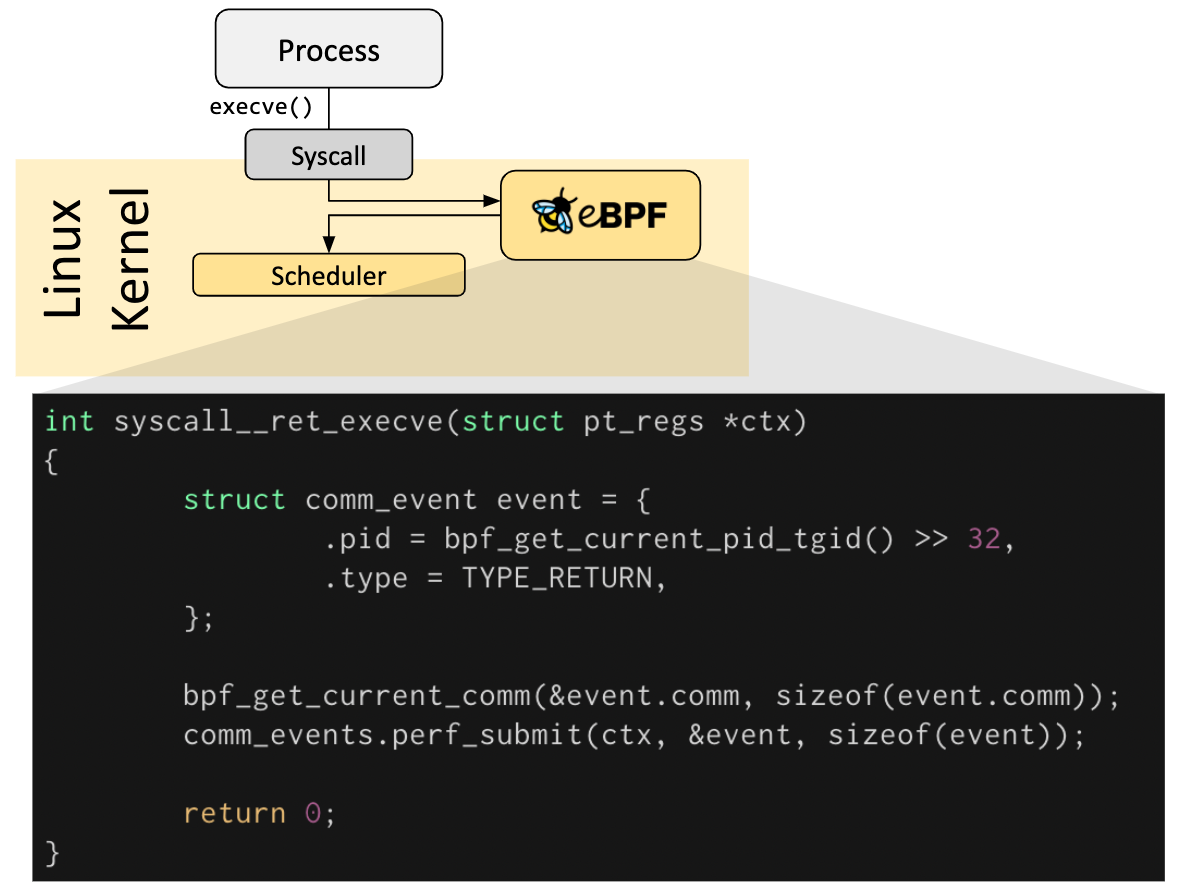
プログラムが実際にどんな形をしているかを示す図だ。プロセスが execve() を呼ぶと、カーネルはスケジューラへ向かう前にフックのプログラムを先に実行する。プログラムは短い。コンテキストを受け取り、ヘルパー関数でPIDとプロセス名を取り出し、perf_submit でユーザースペースにイベントを上げ、0を返す。
三つのことがそのままネットワーク側につながる。プログラムはイベントが起きたときだけ動く(パケットがvethに到着、connect() 呼び出し)。プログラムは戻り値でカーネルに指示する。tcフックなら、通過・ドロップ・別インターフェースへのリダイレクトが戻り値だ。そして perf_submit がCiliumの可観測性ツールHubbleの原型だ。データパスがパケットを判断するたびに、その判断を同じ方法で外へ出す。
2.3 Cで書いてバイトコードにコンパイルする
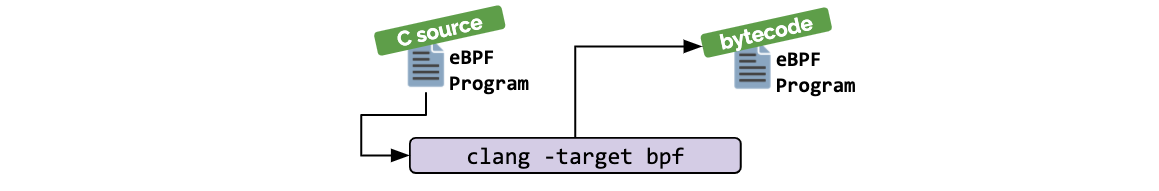
ドキュメントはまず「ほとんどの人はeBPFを直接書かず、Cilium、bcc、bpftraceのようなプロジェクトを通じて間接的に使う」と書いている。Kubernetesの運用者はまさにそのケースだ。それらのプロジェクトの中では、Cのサブセットで書いたソースをLLVMがx86でもARMでもないeBPFバイトコードにコンパイルする。eBPFはカーネルの中に住む小さな仮想マシンで、バイトコードはそのマシンの命令だ。
Ciliumでは、Cソースはリポジトリの bpf/ ディレクトリにあり、エージェントイメージに入ったclangがノード上でコンパイルする。ノードごとにカーネルのバージョンや設定が違いうるので、そのノードに合わせてコンパイルするのだ。
2.4 ローダー — bpf() システムコールでカーネルに載せる
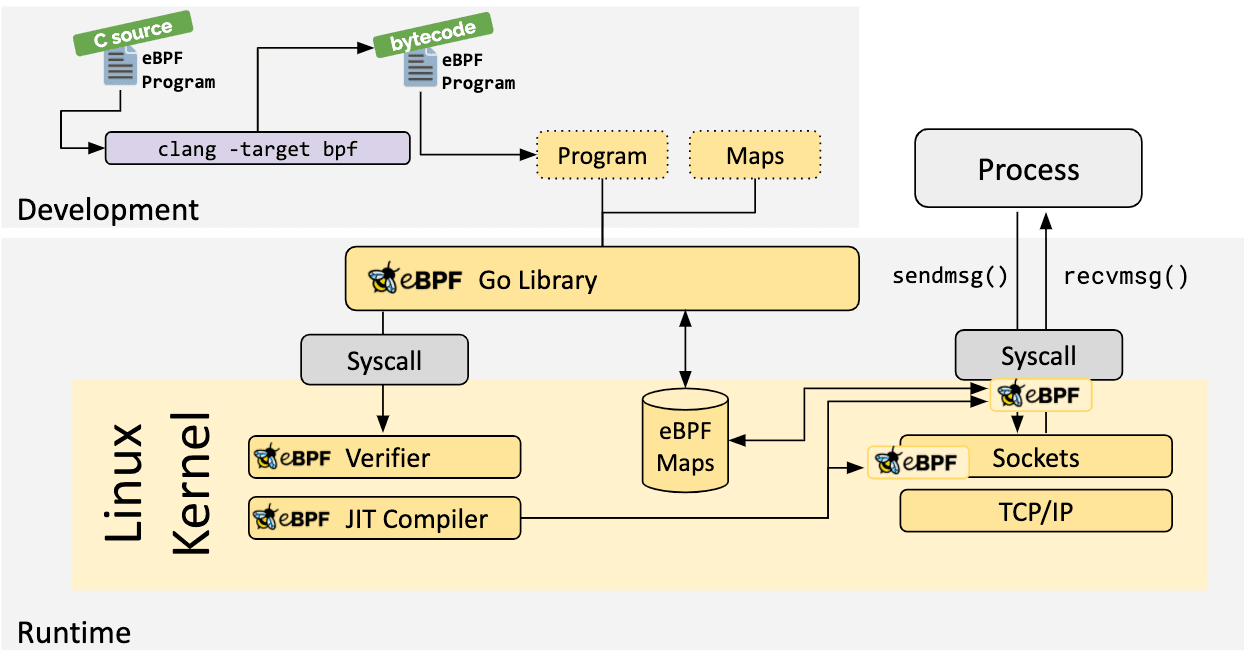
全体図だ。バイトコードとマップ定義が Go Library に入り、ライブラリが bpf() システムコールでカーネルに渡す。カーネルの中でVerifierとJITを経たプログラムがフックに差し込まれ、eBPF Mapsにはライブラリとプログラムの両方から矢印が入ってくる。
この図のGo Libraryは比喩ではない。Ciliumでこの位置に立つのが cilium-agent だ。Goで書かれ、cilium/ebpf ライブラリで bpf() を呼ぶ。前回の記事でiptablesを「カーネルのNetfilterにルールを登録するユーザースペースの道具」と整理したが、エージェントはその位置に立つプログラムとマップを登録するユーザースペースの道具だ。登録が済むとエージェントはパケット経路から外れる。エージェントがしばらく死んでも、すでに差し込まれたプログラムは動き続ける。
2.5 検証器とJIT — 載る前の二つの関門
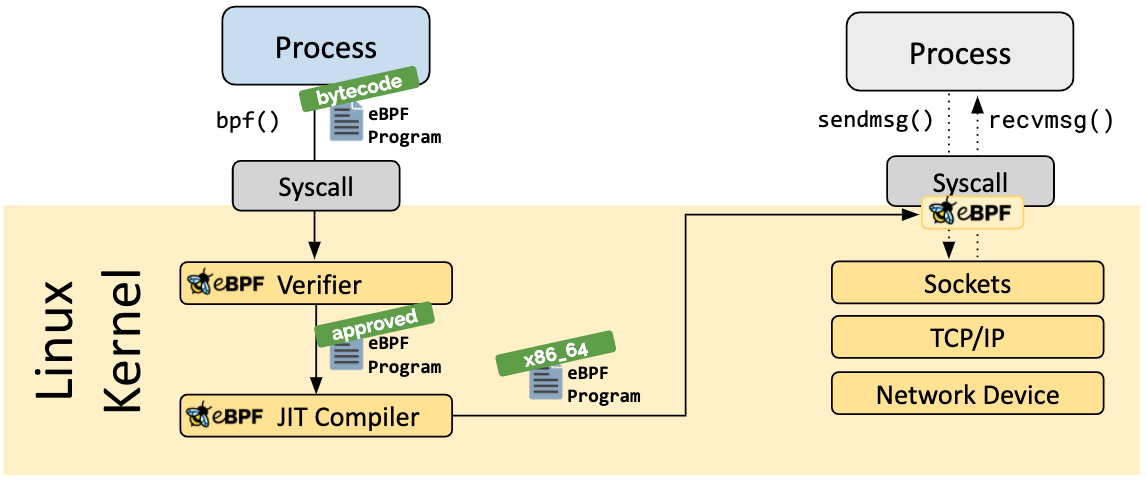
bpf() で渡されたバイトコードはすぐには実行されない。図の緑のタグが状態の変化だ。bytecode → approved → x86_64。 二つの関門を通る。
検証器(verifier)は実行前にすべての経路を静的に検査する。必ず終了しなければならず(無限ループ禁止)、範囲外のメモリに触れてはならず、サイズと複雑さに上限があり、ロードにはrootか CAP_BPF が必要だ。この関門がカーネルモジュールとの決定的な違いだ。モジュールはどんなコードでも載せられるのでカーネルを殺せるが、eBPFはカーネルが安全だと証明したものしか入らない。Ciliumがカーネルのバージョンにうるさい理由もここにある。古い検証器はCiliumのプログラムのサイズと複雑さを受け付けない。
JIT(Just-In-Timeコンパイラ)は通過したバイトコードをそのマシンのネイティブ命令に変換する。もともとカーネルにあったコードと同じ速度で動く。「カーネルの中の仮想マシン」という言葉から想像しがちなインタプリタのオーバーヘッドは、実際には存在しない。
2.6 マップ — カーネルとユーザースペースが共有するストレージ
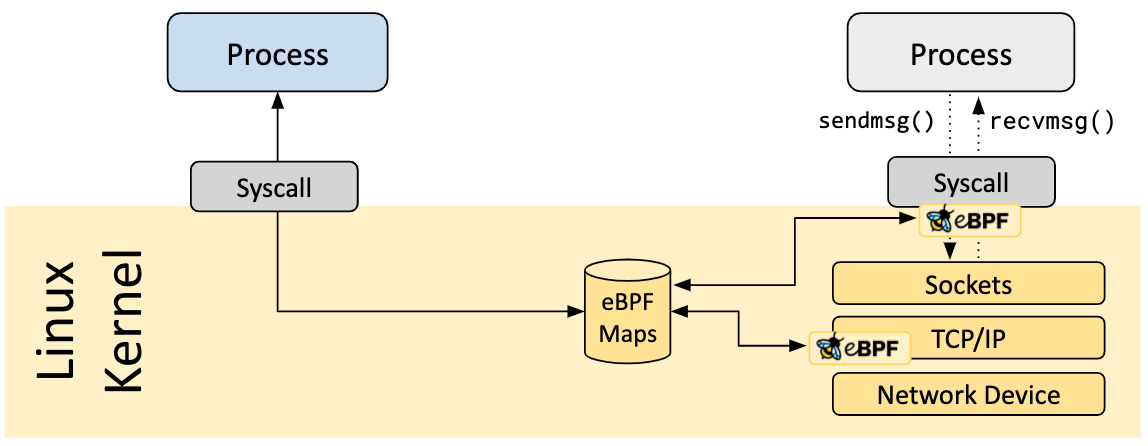
プログラムは呼び出しが終わるとスタックが消える。呼び出しをまたいで残すべき状態はマップ(map)に置く。図では円筒に三本の矢印が入ってくる。ユーザースペースから一本、異なるフックのプログラムから二本。ユーザースペースのローダーは bpf() で読み書きし、プログラムはヘルパーで読み書きする。エージェントとカーネルのプログラム、そしてプログラム同士が同じマップを見る。
マップには種類があり、種類ごとにデータ構造が違う。ドキュメントが列挙する種類はCiliumのマップとこう対応する。
| マップの種類 | データ構造 | Ciliumでは |
|---|---|---|
| Hash | ハッシュテーブル | policy(ポリシー)、lb(Service → バックエンド) |
| LRU hash | 古い項目を追い出すハッシュ | ct(接続追跡) |
| LPM trie | 最長プレフィックス一致のトライ | ipcache(IP → Identity、所属ノード) |
| Array / per-CPU array | 固定サイズの配列 | 設定値、カウンタ |
| Perf / ring buffer | カーネル → ユーザースペースのイベントキュー | Hubbleのイベント |
ルーティングテーブルがやっていたLPM検索が同じデータ構造でマップの中へ移り、iptablesチェーンがやっていたポリシー判断がハッシュ検索へ移ったわけだ。この違いが規模とどう出会うかは4章で見る。
2.7 ヘルパーとテールコール
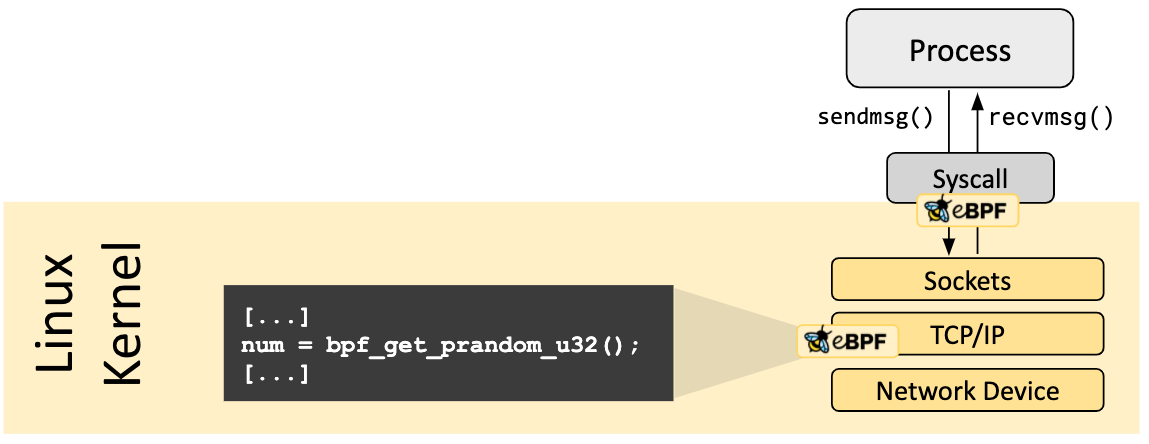
プログラムは任意のカーネル関数を呼べない。カーネルが安定したAPIとして約束したヘルパー関数だけを呼ぶ。乱数一つを得るにも、図のように bpf_get_prandom_u32() を使う。Ciliumがパケットを別のインターフェースへ渡す bpf_redirect、ヘッダを書き換える bpf_skb_store_bytes、マップを引く bpf_map_lookup_elem はすべてヘルパーだ。カーネル内部の関数を直接呼べないようにしてあることが、検証器が安全性を証明できる前提だ。
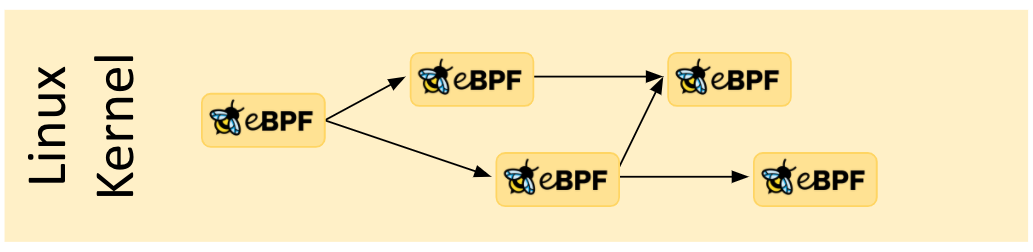
プログラムは別のプログラムへ戻らずにジャンプすることもできる。テールコール(tail call)だ。検証器のサイズ上限のせいで一つのプログラムに収まらないロジックを複数のプログラムに分けてつなぐ手段で、CiliumはPod一つのパケット処理をこの方法で複数のプログラムに分けている。
2.8 まとめ
| 要素 | 役割 | Ciliumでは |
|---|---|---|
| プログラム | フックで実行されるコード。パケットを読み、直し、送るか捨てるかを判断する | bpf_lxc.c、bpf_host.c、bpf_overlay.c、bpf_sock.c |
| マップ | カーネルに住むキーバリューストア。プログラム同士、そしてユーザースペースと共有 | ipcache、policy、ct、lb |
| フック | プログラムが付くカーネルの地点 | tc、cgroup socket、XDP |
一文にまとめるとこうだ。カーネルを再ビルドもモジュール追加もせず、検証器が安全を証明した小さなプログラムをカーネルの決められた要所に取り付けてイベントごとに実行し、そのプログラムとユーザースペースがマップで状態を共有する機能。 1章のConfigurationの箱が「データを渡す通路」だったなら、eBPFはコードを渡す通路だ。
3. ネットワークフック — Netfilterの五つの隣にもう三つ
2章でフックが何かを見たので、今度はネットワーク経路のフックが正確にどこに置かれるかを見る。OSネットワーク内部構造でNetfilterの五つのフック(PREROUTING、INPUT、FORWARD、OUTPUT、POSTROUTING)を整理した。eBPFのフックはその五つとこう並ぶ。
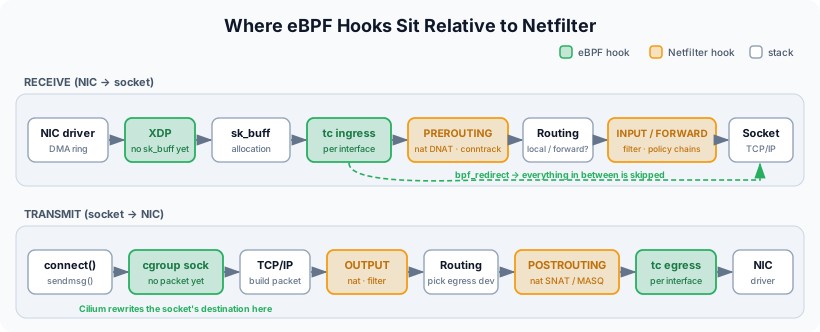
| フック | 位置 | Netfilterとの順序 |
|---|---|---|
| XDP | NICドライバがパケットを受け取った直後。sk_buff が作られる前 | PREROUTING よりずっと前。物理NICの受信専用 |
| tc ingress / egress | インターフェースごと。受信はスタックに上がる直前、送信はドライバに渡す直前 | ingressは PREROUTING の前、egressは POSTROUTING の後 |
| cgroup socket | connect()、sendmsg()、getpeername() システムコールの中 | パケットがまだ存在しない |
tc ingressの位置が核心だ。ホスト側vethのtc ingressはPodから出たフレームがホストスタックに上がる前、つまりブリッジ検索もルーティング検索もNetfilterもまだ一つも起きていない地点だ。ここでプログラムが bpf_redirect でパケットを別のインターフェースへ直接渡してしまえば、その後ろのすべてが飛ばされる。Cilium公式ドキュメントのデータパスの図がこれをそのまま示している。
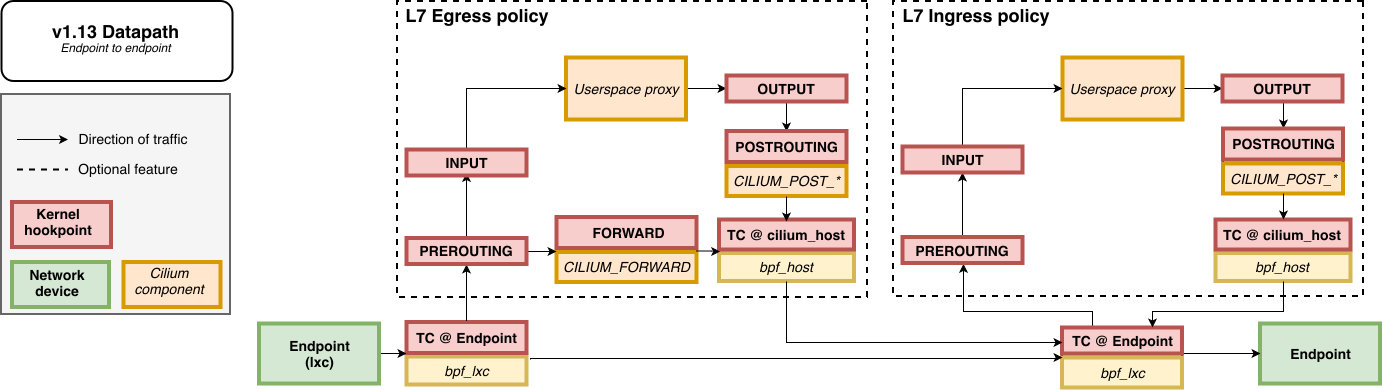
同じノードの二つのPodの間だ。左のEndpointを出たパケットは TC @ Endpoint(bpf_lxc)に捕まり、下の実線に沿って右のEndpointの bpf_lxc へ直接向かう。図では PREROUTING、FORWARD、POSTROUTING がすべて点線の箱の中、つまりL7ポリシーを有効にしたときだけ通る任意の経路にある。Netfilterが既定の経路から外れているということだ。
最初のパズルで conntrack -L が空だった理由の半分がここにある。パケットがNetfilterを通らなかったので、カーネルのconntrackに見る機会がなかった。残りの半分はcgroupソケットフックにあり、5章で見る。
4. マップが速い理由 — チェーンをなめることとハッシュを引くこと
3章では、eBPFがNetfilterより手前でパケットを捕まえるという位置の違いを見た。しかし位置だけが違うなら「少し早めに処理する」程度の利点だ。Podが数千個規模に増えたときに体感される違いは、位置ではなくデータ構造から来る。
4.1 iptablesチェーンは上から下へなめる
kube-proxyのiptablesモードがServiceをどう実装しているかを思い出そう。KUBE-SERVICES チェーンにServiceごとにルールが一行ずつあり、一致したルールが KUBE-SVC-* チェーンにジャンプし、そこでエンドポイントごとに確率ルールが一行ずつあって KUBE-SEP-* チェーンにジャンプし、そこでDNATがかかる。
-A KUBE-SERVICES -d 10.96.45.10/32 -p tcp --dport 80 -j KUBE-SVC-NGINX
-A KUBE-SERVICES -d 10.96.45.11/32 -p tcp --dport 80 -j KUBE-SVC-API
-A KUBE-SERVICES -d 10.96.45.12/32 -p tcp --dport 5432 -j KUBE-SVC-DB
... (Serviceの数だけ)
-A KUBE-SVC-NGINX -m statistic --mode random --probability 0.33333 -j KUBE-SEP-A
-A KUBE-SVC-NGINX -m statistic --mode random --probability 0.50000 -j KUBE-SEP-B
-A KUBE-SVC-NGINX -j KUBE-SEP-C
... (エンドポイントの数だけ)
Netfilterはチェーンのルールを上から下へ一つずつ比較する。パケットの宛先が KUBE-SERVICES の1,000行目にあれば、999回比較してからようやくジャンプする。ルール数は Service数 × エンドポイント数 に比例して増え、パケットあたりの最悪の照合コストがその数に比例する。線形探索、O(n)だ。
conntrackがこのコストをかなり隠す。フローの最初のパケットだけがチェーンを最後まで下り、接続が登録された後のパケットは --ctstate ESTABLISHED の一行で通過する。だから長寿命の接続が多いワークロードではチェーンの長さはあまり感じられない。問題は新しい接続が大量に生まれるワークロードと、次節の更新コストだ。
4.2 更新コスト — Podが一つ立つたびにテーブル全体を書き直す
検索より痛いのが更新だ。iptablesはルール一つを直すときでも、カーネルからテーブル全体を読み出して修正し、丸ごと載せ直す構造だ。だからkube-proxyはルールを一行ずつ入れる代わりに、エンドポイントが変わるたびに iptables-restore で関連テーブル全体を一度に書き直す。Serviceが数千あればルールは数万行で、Podが一つ立ったり消えたりするたびにその数万行を丸ごと差し替える。ローリングアップデート中にPod数百個が連鎖的に入れ替わると更新が更新に追いつかず、その間に死んだPodへトラフィックが行ったり、新しいPodがトラフィックを受け取れない区間が生じる。kube-proxyの minSyncPeriod オプションはこの更新をまとめて減らすための緩衝装置で、Kubernetesがnftablesモードを新たに作ったのも同じ問題のためだ。
NetworkPolicy側は少し違う。CalicoのFelixはセレクタをipsetにしてルールはそのままにし、集合のメンバーだけを変えるので、Podが立ったり消えたりするときにポリシールールを書き直すコストはない。しかしチェーン自体は依然としてNetfilterの中にあり、判断の根拠がIPである点もそのままだ。ノードごとに、そのIPがどのPodかを知る状態を維持しなければならない。
4.3 eBPFマップはキーで直接引く
同じことをeBPFマップでやるとこうなる。
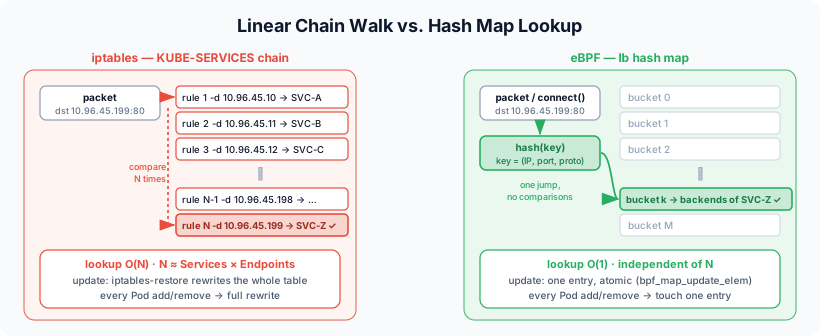
Serviceの検索は lb マップで (ClusterIP, ポート, プロトコル) をキーにハッシュ一回だ。Serviceが10個でも10,000個でもコストは同じ。ポリシーの検索は policy マップで (送信元Identity, ポート, プロトコル) をキーにハッシュ一回。送信元IPをIdentityに変換する ipcache の検索はLPMトライなので、プレフィックス長に比例するだけで項目数とは無関係だ。ルールが数千あっても、パケット一つが払うコストは変わらない。
更新も違う。マップは項目単位でアトミックに読み書きする。Podが一つ立てば ipcache に一行、lb にバックエンド一行が入るだけで、残りの項目には触れない。テーブル全体を書き直すことがないので、Pod数百個が連鎖的に入れ替わっても更新が滞らない。
| iptablesチェーン | eBPFマップ | |
|---|---|---|
| 検索 | ルールを上から下へ比較。ルール数に比例 | キーでハッシュ。ルール数と無関係 |
| 更新 | テーブル全体を書き直して差し替え | 項目一つをアトミックに差し替え |
| Podが1,000個立つと | ルール数千行を追加、そのたびに全体を再作成 | ipcache・lb に項目1,000個を追加 |
| 検索コストを隠すもの | conntrack(最初のパケット以降) | 自前の ct マップ(同じ役割) |
4.4 では、いつ体感されるのか
正直に書いておくと、ノード数台にPod数十個のクラスタではこの違いは感じられない。iptablesのルールが数百行なら線形探索でも十分速く、更新も滞らない。違いが現れる条件は三つが重なるときだ。ServiceとPodが数千個規模で、新しい接続が頻繁に生まれ、Podが頻繁に立ったり消えたりする環境。大規模なマルチテナントクラスタや、バッチワークロードが押し寄せるクラスタがここに当たる。
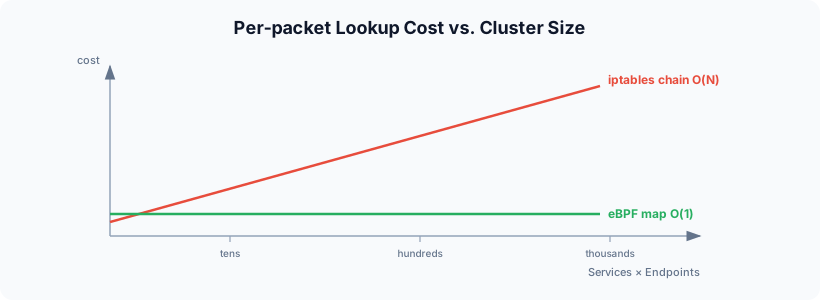
その規模ではiptablesモードのパケットあたりコストと更新コストが一緒に増えていくのに対し、eBPFマップはどちらも平らなままだ。前回の記事で「iptablesはO(n)、CiliumはO(1)」と一行で書いたことの実体がこれだ。データ構造を変えたから規模に対するコスト曲線の傾きが変わったのであって、同じことを少し速くやっているのではない。
5. 脇道 — CiliumはeBPFをこう使う
ここまでがeBPFの構造と、その構造が規模において持つ利点だ。この章では、その構造をCiliumが実際にどう組み立てたかを短く見る。深くは入らず、前に見たプログラム・マップ・フックがどこで使われているかだけを押さえる。
5.1 部品
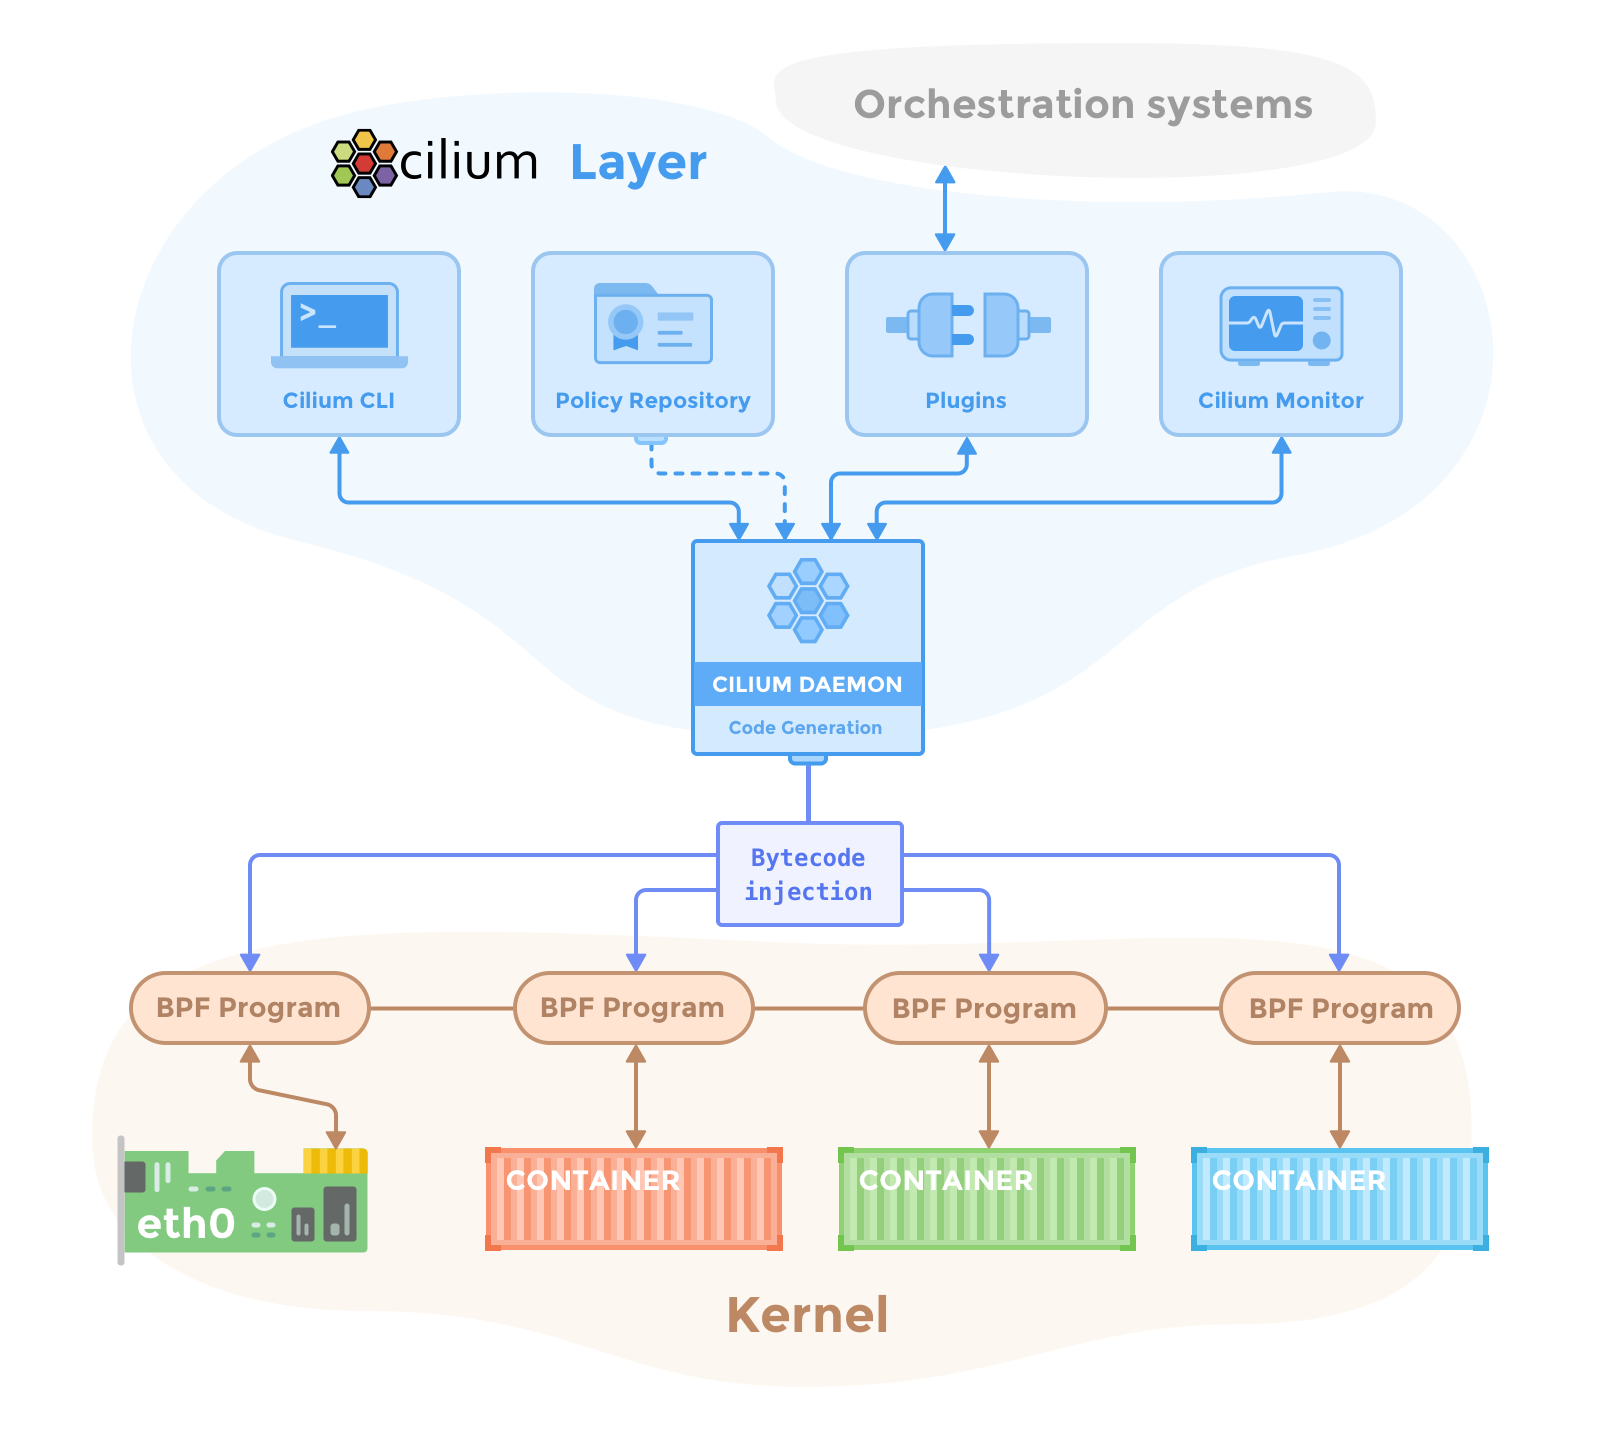
出典: Cilium — Component Overview
公式の図は二層だ。上のCilium Layerにデーモン(エージェント)とその周辺ツールがあり、デーモンが Code Generation → Bytecode injection で下のKernel層のBPF Programを作って差し込む。カーネル層を見ると、プログラムがコンテナごとに一つ、そして eth0 に一つ付いている。2.4節のebpf.ioの図をCiliumに合わせて描き直したものだ。
| コンポーネント | デプロイ形態 | やること |
|---|---|---|
Agent(cilium-agent) | DaemonSet、ノードごと | Pod・Service・ポリシーのイベントを受け取り、そのノードのeBPFプログラムとマップを管理する。2.4節のローダー |
CNI Plugin(cilium-cni) | 実行ファイル、Podの作成・削除時 | ランタイムに呼ばれると、ノードのエージェントに「このPodのデータパスを構成してくれ」と依頼する |
Operator(cilium-operator) | Deployment、クラスタに一つ | IPAM、Identityなど、クラスタに一度で済む仕事。転送経路にいない。 死んでもトラフィックは流れる |
| Hubble | エージェント内蔵 + Relay + UI | データパスがperfバッファへ出した判断をフローに加工して見せる |
ノードで実際に見えるのはこうだ。Podのホスト側vethごとにtcプログラムが付いている。
$ ip -br link | grep -E 'cilium|lxc'
cilium_net@cilium_host   UP          # ホストスタックとeBPFの間のvethペア
cilium_host@cilium_net   UP          # PodのゲートウェイIPがここに付く
lxc1a2b3c4d5e6f@if12     UP          # Podのホスト側veth — Flannelのveth…、Calicoのcali…の位置

$ tc filter show dev lxc1a2b3c4d5e6f ingress
filter ... bpf ... cil_from_container direct-action ...
5.2 パケットが通る道
node-1のPod Aがnode-2のPod Bへ送るパケットは五つの段階を通る。
- Podを出たフレームが
lxcのtc ingressでbpf_lxcに捕まる。 ブリッジもルーティングテーブルもiptablesもまだ見ていない - 三つのマップを引く。
ct(既知の接続か)、ipcache(宛先IPはどのIdentity・どのノードか)、policy(そのIdentityへ送ってよいか)。すべてハッシュまたはLPM検索だ - ノード間を渡る。 トンネルモードならVXLANで包み、native routingならホストのルーティングテーブルに任せる
- 受信ノードの
bpf_hostが受け取って宛先Endpointを探し、そのEndpointのingressポリシーを見る。 やはりipcacheとpolicyの検索だ - 宛先Podのvethへ直接入れる。 ホストのルーティングも
FORWARDチェーンも通らない
前回の記事のFlannelではノード間の経路をルート・ARP・FDBの三行が決め、CalicoではBGPが学んだルート一行が決めていた。Ciliumのトンネルモードではその役割が ipcache マップの一項目へ移る。接続追跡も自前のものを持つ。最初のパケットがポリシーを通過すると ct マップに記録され、同じ接続の後続パケットと応答はポリシーを再評価しない。Calicoが --ctstate ESTABLISHED -j ACCEPT の一行でやっていたことを、同じ構造で別のストアでやっている。Ciliumの接続は conntrack -L ではなく cilium bpf ct list にある。
5.3 kube-proxyの置き換え — パケットが生まれる前に終わらせる
最初のパズルの残り半分だ。Podの中のcurlが connect(10.96.45.10:80) を呼ぶ。システムコールがカーネルに入ると、パケットが作られる前にルートcgroupに付いたプログラムが実行される。プログラムは lb マップでServiceを探し、バックエンドを一つ選んでソケットの宛先アドレスそのものをPod IPに書き換える。その後カーネルはごく普通にPod IPへSYNを作る。Podの eth0 にも、どのワイヤにも、ClusterIPは一度も存在しなかった。
| kube-proxy iptables | CiliumソケットLB | |
|---|---|---|
| 変換のタイミング | 最初のパケットが PREROUTING に来たとき | connect() の中 |
| 変換の対象 | パケットヘッダ。応答はconntrackが戻す | ソケットの宛先。応答はそのままPod IPへ戻ってくる |
| パケットごとのコスト | 最初のパケットでチェーンスキャン、以降はconntrack検索 | 0。 接続ごとに一回 |
iptables -t nat | KUBE-SVC-* チェーン | なし。cilium bpf lb list |
KUBE-SVC-* がないのはkube-proxyがいないので当然で、conntrack が空なのはDNATがソケット段階で終わり、Netfilterに変換するものがなかったからだ。変換がなければ戻すものもなく、戻すものがなければconntrackも要らない。 アプリケーションはこのことを知らない。getpeername() を呼ぶと、同じcgroupフックのプログラムが横取りして元のClusterIPを返す。
ソケットのないパケットもある。クラスタの外からNodePortに入ってくるパケットには connect() を呼んだプロセスがないので、eth0 のtcプログラムまたはXDPがパケットヘッダにDNATをかける。ソケットLBが一つ目の網で、tcが二つ目の網だ。
5.4 Identity — IPの代わりに番号で判断する
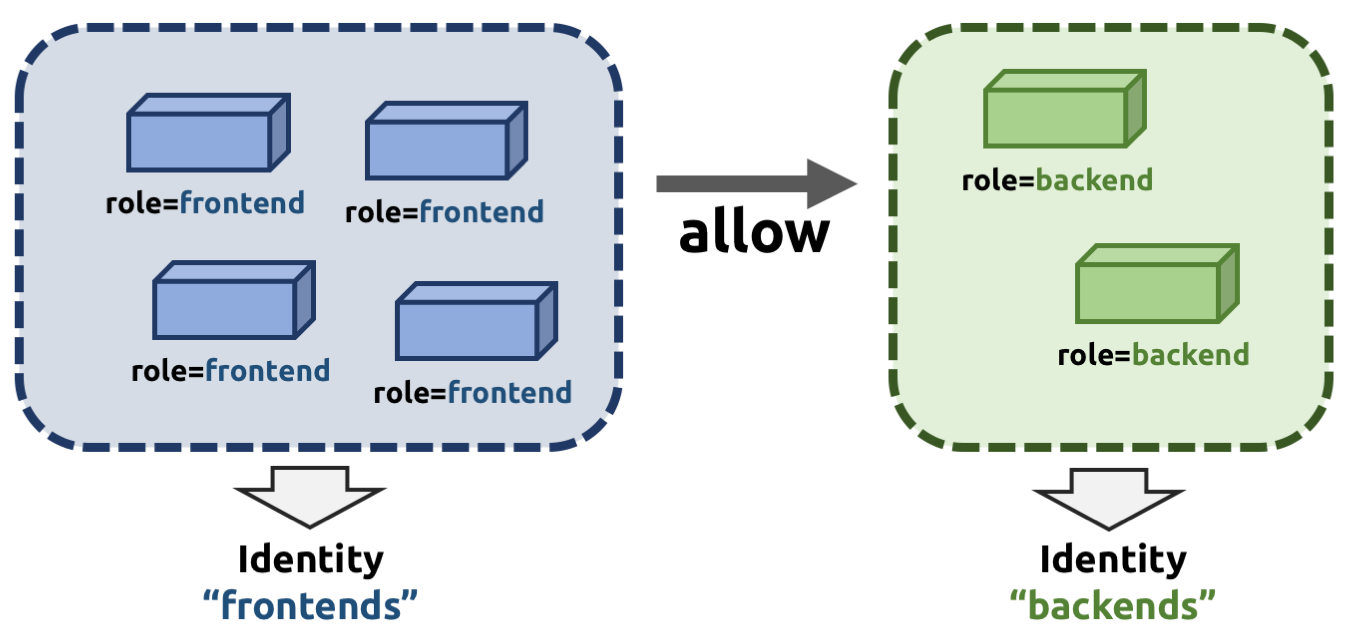
出典: Cilium — Identity-Based Security
4章の policy マップのキーにIPではなくIdentityが入っているのが、Ciliumのもう一つの設計だ。公式の図が核心をすべて語っている。role=frontend のPodは何個あっても Identity “frontends” 一つにまとめられ、ポリシーはfrontends → backendsの間の allowの矢印一本だ。Podが増えても矢印はそのままだ。
Podが立つと、エージェントはセキュリティ上意味のあるラベル(app=frontend、namespaceなど)を集めてソートし、その集合にクラスタ全体で一意な番号を一つ割り当てる。CiliumIdentity CRDに保存されるので、すべてのノードが同じ番号を見る。
ポリシーはこの番号同士の関係として保存される。「frontend → backend 80/TCP 許可」は、backendの policy マップの (1234, 80, TCP) → allow という一行だ。frontendのPodが4個から40個に増えてもこの一行はそのままで、ipcache にだけ IP → 1234 の行が36本増える。4.3節で見た「更新は項目単位」という利点の上に、ポリシー側はPod数とまったく無関係になるようにしたわけだ。
6. 脇道 — Calicoを並べて置くと
5章でCiliumを見たので、同じ位置にCalicoを置いて比較する。前回の記事でCalicoを「netfilterの上に積み上げた成熟したアーキテクチャ」とまとめたが、4章の目で見直すとその言葉の意味がもう少し具体的になる。
Calicoの既定のデータプレーンはiptablesだ。各ノードのFelixが filter テーブルの FORWARD チェーンに cali-FORWARD を掛け、インターフェース名で分岐してPodごとに cali-fw-(from-workload)、cali-tw-(to-workload)チェーンを置く。ポリシーはPodのvethのすぐ手前で評価される。セレクタはipsetにしてルールはそのまま、メンバーだけを変え、最初のパケット以降はconntrackが通す。ノード間はBGP、IPIP、VXLANのいずれかで渡る。Serviceはkube-proxyに任せる。
この構造の長所は、1章の設定インターフェースの中にとどまっていることだ。 ip route、iptables -S、ipset list、conntrack -L で最後まで読める。カーネルのバージョンを選ばず、運用者がすでに知っている道具でデバッグする。短所は4章そのままだ。チェーンは線形で、Serviceのルールはkube-proxyが全体再作成で更新し、判断の根拠がIPなのでノードごとに IP → Pod の状態を持っていなければならない。
| 観点 | Calico(iptablesモード) | Cilium(eBPF) |
|---|---|---|
| パケット処理の位置 | Netfilterの FORWARD チェーン | tc ingress、Netfilterの手前 |
| ポリシー検索 | チェーンの線形探索 + ipsetメンバー確認 | policy ハッシュマップ |
| ポリシー更新 | ipsetメンバー変更(ルールはそのまま) | マップ項目のアトミックな変更 |
| Service | kube-proxy iptables。全体再作成で更新 | lb マップ + ソケットLB。項目単位で更新 |
| 接続追跡 | カーネルのconntrack | 自前の ct マップ |
| 判断の根拠 | IP(ノードごとのipset) | Identity(クラスタ全体の番号) |
| ノード間 | BGP / IPIP / VXLAN | VXLAN・Geneve / native routing |
| デバッグツール | iptables、ipset、conntrack、tcpdump | cilium bpf *、hubble observe、bpftool |
| カーネル要件 | 特になし | 5.10以上(最近のCiliumバージョン基準) |
公平を期すために一つ付け加えておく。CalicoにもeBPFデータプレーンがある。 有効にすれば、tcフック、自前の接続追跡マップ、kube-proxyの置き換えまで、Ciliumと同じ骨格を持つ。違うのはその上のモデルだ。Calico eBPFはIPベースのポリシーモデルをそのままにデータプレーンだけを替えたものなのでiptablesモードに戻れるが、CiliumはIdentityを前提に設計されていてiptablesモードがない。 だから「Calico対Cilium」より正確な比較は「iptablesチェーン対eBPFマップ」で、この記事が4章にいちばん多くの紙幅を使った理由でもある。
おわりに
この記事は、前回の記事で一段落だけで済ませた「CiliumはeBPFでnetfilterを迂回する」を展開したものだ。展開してみると三層だった。eBPFは、設定インターフェースがデータを渡していた位置にあるコードを渡す通路で、そのコードは検証器が安全を証明した後にJITでネイティブ速度で動き、状態はマップでカーネルとユーザースペースが共有する。ネットワークフックはNetfilterより手前(tc)と上(ソケット)に置かれていて、そこで処理が終わればNetfilterはパケットを見る機会すらない。そしてその処理がハッシュマップ検索なので、Podが数千個になってもパケット一つのコストと更新一つのコストは平らなままだ。
整理していていちばん印象に残ったことは二つある。一つは、移された判断の構造そのものは見慣れないものではなかったことだ。ct マップはconntrackで、ipcache はルーティングテーブルとFDBを合わせたもので、policy マップはCalicoのチェーンで、lb マップは KUBE-SVC-* チェーンだった。前回の記事で見たデータ構造の一つ一つにマップが一つずつ対応していた。変わったのは、検索がすべてハッシュで規模に無関係になったことと、そのストアをユーザースペースの道具ではなくカーネルの中のプログラムが直接読むことだ。もう一つは、DNATがパケットからシステムコールへ上がったことだ。conntrackをアドレス変換の前提として受け入れていたが、変換をパケットが生まれる前に終わらせれば、conntrackのやることがそもそもなくなる。データ構造を変えたのではなく、問題が生じる層を変えて問題をなくしたのであり、だから conntrack -L が空なのは欠陥ではなく設計だった。
逆に、この利点がタダではないことも明らかになった。カーネルのバージョンを選び、デバッグツールが丸ごと変わり、ノード数台のクラスタでは体感すらできない。iptablesが遅いからCiliumを使うのではなく、iptablesのコスト曲線が問題になる規模に達しているかが判断基準だ。その規模にいないなら、iptables -S で最後まで読める側のほうが運用には楽かもしれない。
次は、Podにインターフェースが二つ以上付く場合を整理してみようと思う。Ciliumのすべての判断はPodの最初のveth一本に付いているので、Multusで二つ目のインターフェースを付けると、そのトラフィックはポリシーもHubbleも見えないはずだからだ。eBPFが「どこに差し込まれているか」がそのまま「何が見えるか」の境界だという点を、その事例で確かめてみるつもりだ。
References
- ebpf.io — What is eBPF?
- Linux kernel — BPF documentation
- cilium/ebpf — Go eBPFライブラリ
- Cilium — eBPF Datapath
- Cilium — Life of a Packet
- Cilium — Component Overview
- Cilium — Kubernetes Without kube-proxy
- Cilium — Identity-Based Security
- Cilium Blog — Why is the kernel community replacing iptables with BPF?
- Kubernetes公式ドキュメント — Virtual IPs and Service Proxies
- Calico — eBPF dataplane
- 以前に書いた記事 — Kubernetesネットワークの本質: CNI、VXLAN、そしてPodはどのように通信するのか