DevOpsエンジニアとして働きながら、SLOやSLAという言葉には何度も触れてきました。ただ、詳しく踏み込んで調べたことはありませんでした。見つかる記事も用語を一行でまとめる程度で止まっていたため、本格的に理解するきっかけを作るのが難しかったのです。
最近、時間を作ってGoogleの Site Reliability Engineering を読んだのですが、この本はSLOの扱い方が違いました。定義を並べる代わりに、「100%の可用性は目標になり得ない」という命題から出発します。そして目標を100%から下げたときに生まれる空きを Error Budget と呼び、デプロイ速度と安定性のあいだの判断をその予算に委ねます。指標ではなく 意思決定の装置 として読めた瞬間でした。
ちょうど社内でもKPIを設定する中でSLOのような合意の領域を覗くことになり、適切なインフラのプロビジョニング基準を考えていくうちに、結局同じ場所に戻ってきました。どれだけ備えれば十分なのか は、どこまで失敗を許容するのか を決めない限り答えが出ない問いだったのです。
この記事はその問いを追いかけた記録です。SLOから始めて100%が不可能な理由を通り、Error Budgetへ、そしてその数字がそもそも何を測っていたのか(SLI)へ、最後にSLAとインフラチームの運用のあり方まで続きます。
1. SLOとは何か
SLOは Service Level Objective の頭文字を取った言葉です。サービスが達成しようとする信頼性の目標値を意味します。ただ、肝心なのは目標という言葉ではなく 合意 だという点にあります。
GoogleのSRE本は、この合意が必要な理由を組織間の構造的な緊張に求めます。プロダクト開発チームは新機能を速く出すことで評価されます。一方SREチームはサービスが落ちないことで評価されます。ところがデプロイは変更であり、変更は障害の最も一般的な原因です。だから一方はより速く出そうとし、もう一方は危険な変更を遅らせようとします。両方の立場がどちらも正当であるため、この対立はどちらが正しいかを問うだけでは終わりません。
SLOはこの議論を 数字についての合意 に変えます。たとえば可用性99.9%をSLOと定めたなら、残りの0.1%は信頼性を少し譲ってでも、より速いデプロイと実験に使える取り分になります。この取り分に名前を付けたものが エラー予算(Error Budget)です。
1.1 目標がなければ判断もない
信頼性は正常か障害かという二値ではなく、連続的な値です。
最近GitHubの障害が頻発し、開発コミュニティではサービスを移すかどうかという話が交わされました。GitHubはステータスページで直近90日間のuptimeを公開しています。
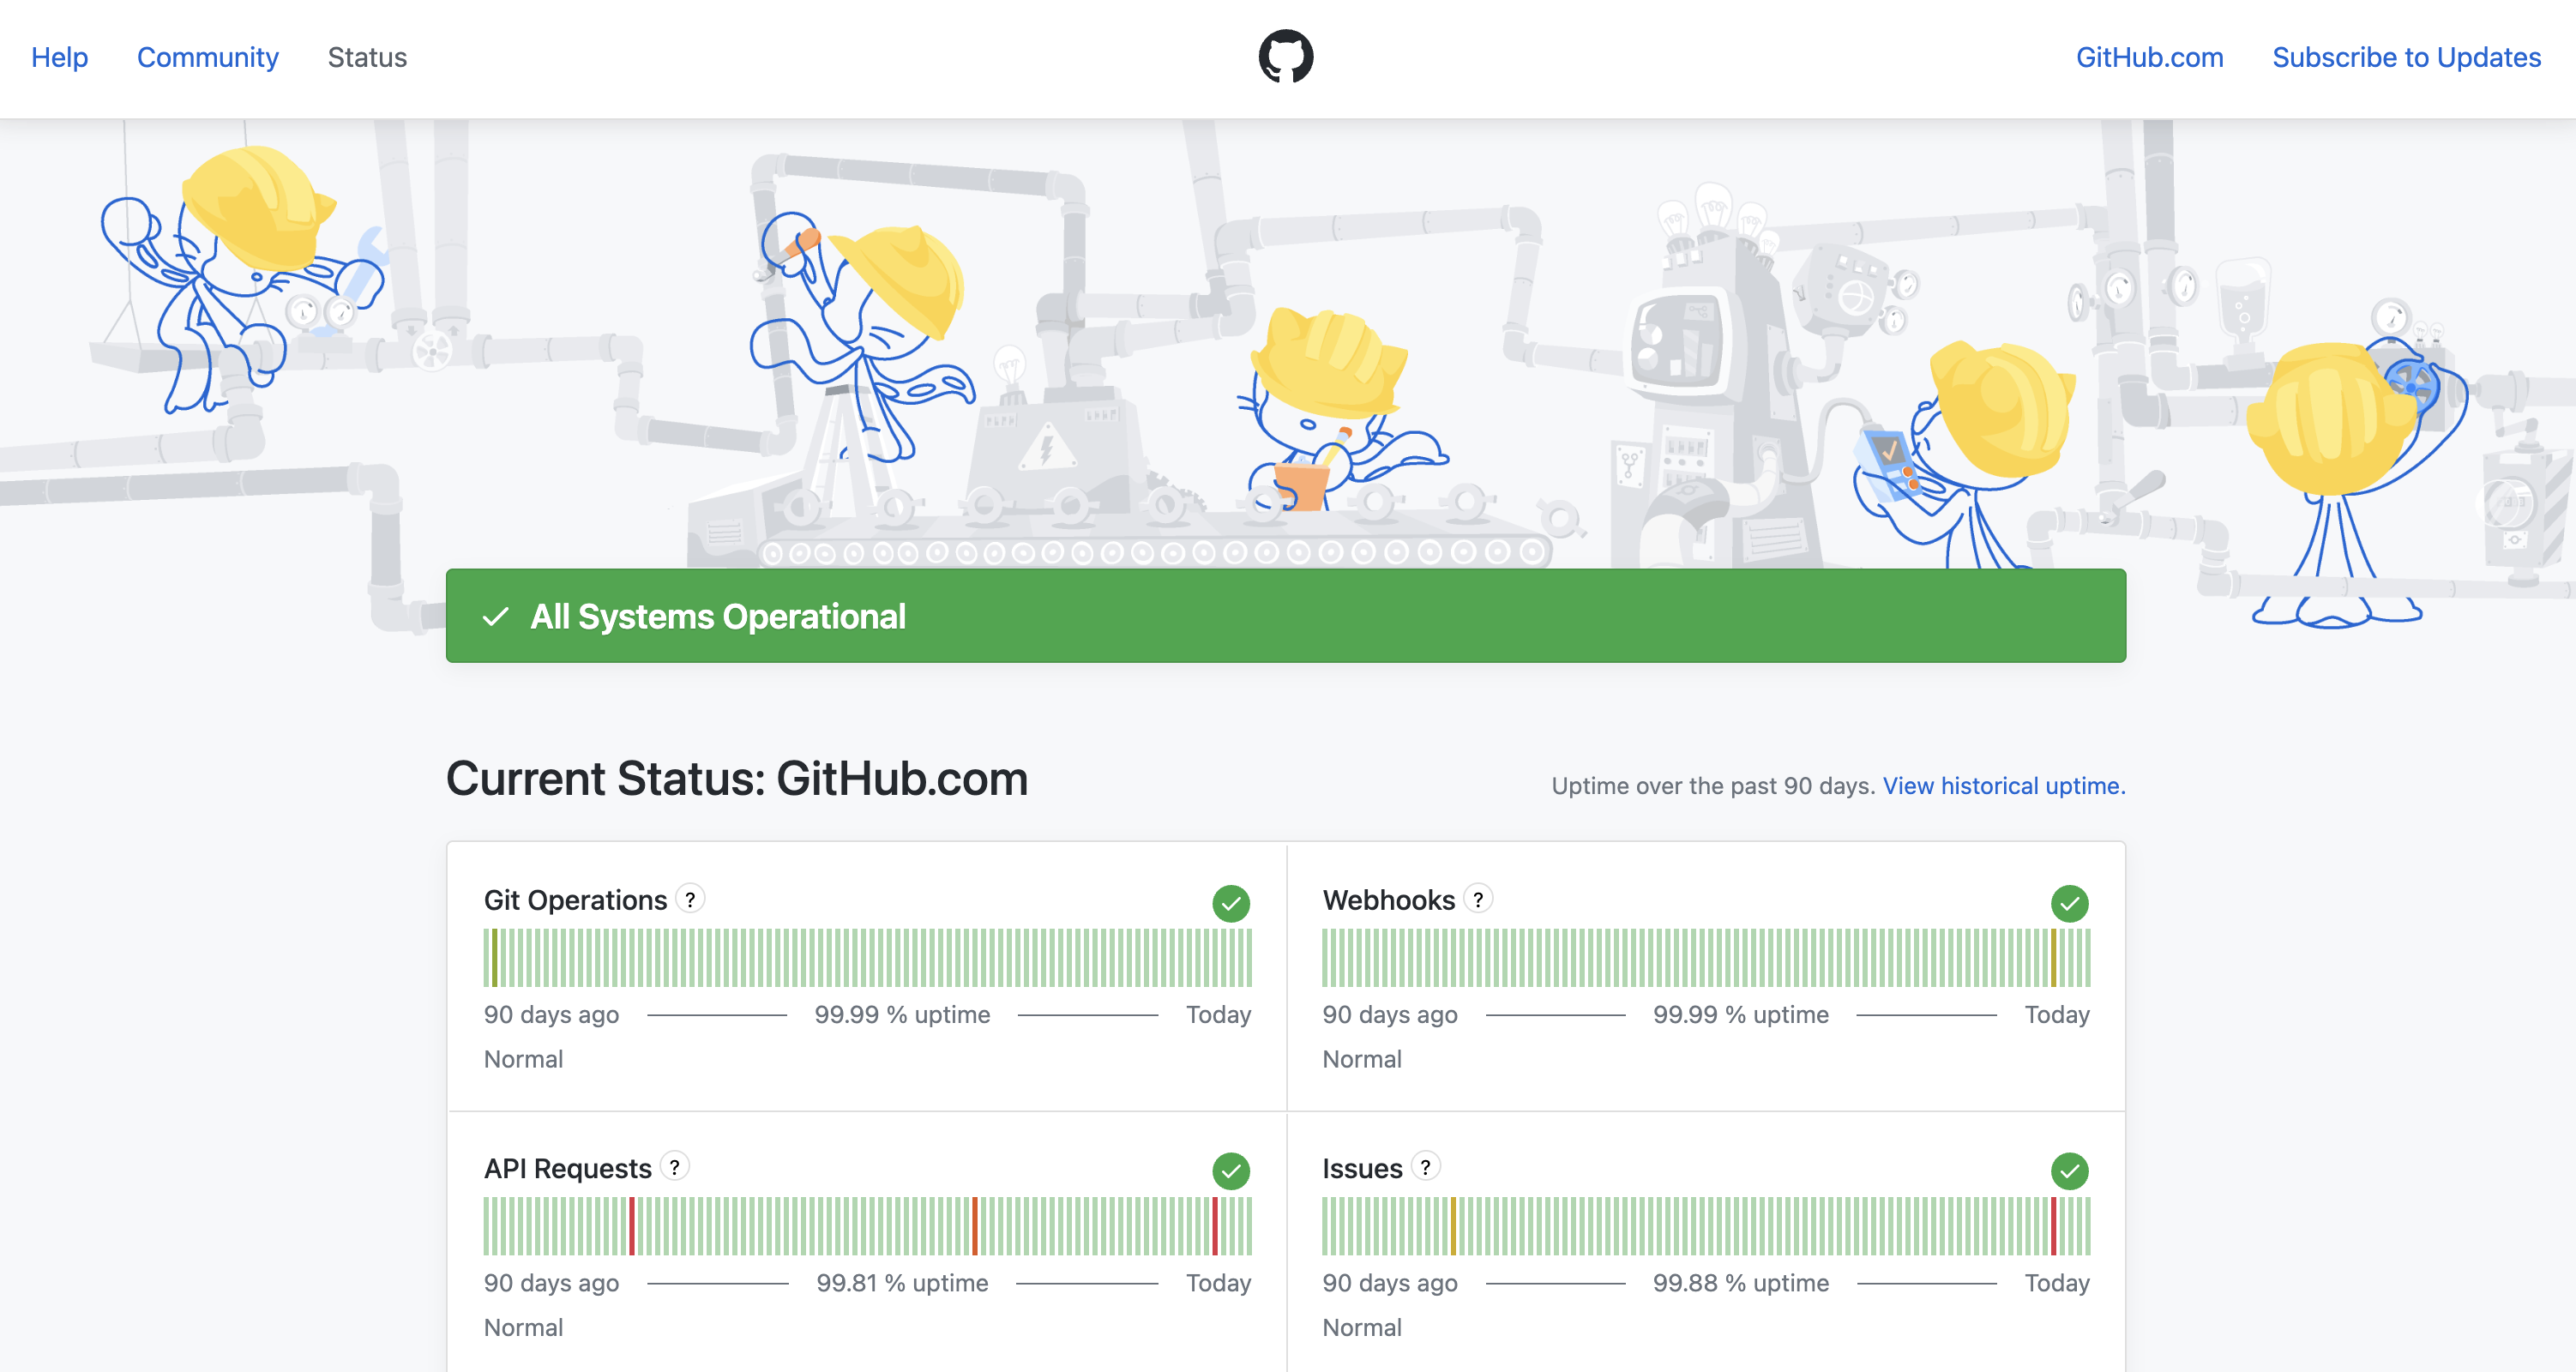
この画面で目を引くのは、上部のバナーが All Systems Operational を示しているにもかかわらず、下のバーには障害の痕跡が色で残っているという点です。今この瞬間は正常でも、90日という窓で見るとこのサービスは何度も揺らいでいます。いま生きているか と どれだけ信頼できるか は別の問いであり、後者は二値では答えられません。
コンポーネントごとに数字が分かれているのも興味深いところです。
| コンポーネント | 90日 uptime |
|---|---|
| Packages | 100.0% |
| Git Operations | 99.99% |
| Webhooks | 99.99% |
| Codespaces | 99.97% |
| Issues / Pull Requests | 99.88% |
| API Requests | 99.81% |
| Pages | 99.65% |
| Copilot | 99.64% |
| Actions | 99.33% |
(2026年8月21日時点、90日ローリングウィンドウ)
同じGitHubなのにPackagesは100.0%で、Actionsは99.33%です。「GitHubは安定しているか」という問いに一つの数字で答えられないという意味です。何を測るかによって答えが変わるのですが、この問題は後のSLIで改めて扱います。
そしてこの小数点は思ったより大きな差を生みます。パーセンテージは直感を裏切るので、許容ダウンタイムに換算してみると感覚が変わります。
| SLO | 月 (30日) | 週 | 日 |
|---|---|---|---|
| 99% | 7時間12分 | 1時間41分 | 14分24秒 |
| 99.9% | 43分12秒 | 10分5秒 | 1分26秒 |
| 99.95% | 21分36秒 | 5分2秒 | 43秒 |
| 99.99% | 4分19秒 | 1分1秒 | 8.6秒 |
| 99.999% | 26秒 | 6秒 | 0.9秒 |
前の表にあるActionsの99.33%は、90日基準で約14時間30分のダウンタイムに相当します。99.9%と99.99%のあいだの距離も、ひと月で43分と4分という、対応の仕方がまるごと変わる間隔です。
目標が定まっていなければ、アラートが鳴ったときに対応すべきことなのか流していいことなのかを判断する根拠がありません。すると全ての障害が同じように緊急になり、優先順位は結局その場で声の大きい人の順に決まってしまいます。SLOを決めるのは、その判断線をあらかじめ引いておく作業です。
1.2 SLOは「高ければ高いほど良い値」ではない
高い可用性を提供することは、普通は美徳と見なされます。しかし目標を設定する立場から見ると、数字を上げることが常に良い選択とは限りません。
ユーザーのリクエストが自分のサーバーに届くまでには、いくつものインフラを経由します。家庭の電気とルーター、ISP回線、DNS、インターネットバックボーンを通り抜けてから、ようやく自分のインフラに到着します。これらの区間はそれぞれ100%ではなく、しかもほとんどが自分では手を出せない領域です。
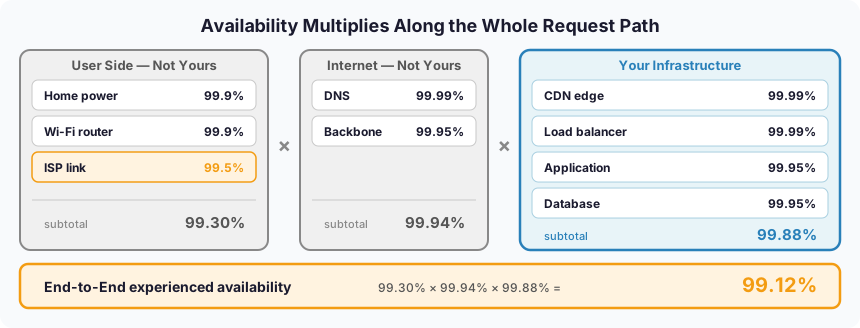
可用性は足し算ではなく 掛け算 です。上の例では自分のインフラは99.88%ですが、ユーザー区間(99.30%)とインターネット区間(99.94%)を合わせて通過した結果は99.12%になります。自分が制御する区間が鎖の中で最も頑丈なのに、全体の数字を引き下げているのは自分では手を出せない側なのです。
ここから導かれる結論があります。自分のインフラの4要素をすべて99.999%まで引き上げても、全体の体感可用性は99.12%から99.24%に上がるだけです。年間ダウンタイムでは約4,612分から4,007分、10時間ほど減る計算になります。その10時間のためにマルチリージョンとマルチクラウドを引き受ける価値があるかは、まったく別の問いです。
ユーザーが体感できない信頼性に対価を払う理由はありません。SLOを決めるときに「できるだけ高く」が答えにならないのは、ここに理由があります。
1.3 だから100%は目標になり得ない
1.2で見た掛け算構造が第一の理由です。自分のサービスの可用性が、依存しているすべてのものの積を超えることはありません。しかもその鎖には、電気や回線のように自分が契約すらしていない項目が混ざっています。100%を主張するには、そのすべての層が100%でなければなりません。
第二は費用です。9を一つ足す費用は線形には増えません。単一インスタンスから冗長化へ、冗長化からマルチAZへ、さらにマルチリージョンとマルチクラウドへ移るたびに必要になるのは機材だけではなく、それを設計し検証し運用する人の時間です。その時間は、機能を作れなかった時間でもあります。
第三は組織です。100%を目標として宣言すると、すべての失敗が「あってはならないこと」になります。すると失敗を学習に変える振り返りの代わりに責任を探す会議が開かれ、変更そのものがリスクとして扱われてデプロイが止まります。失敗の許容量を明示しない組織は、失敗から学べません。
だから発想を逆にします。どれだけ落ちないか を問う代わりに、どれだけ落ちても大丈夫か を決めるのです。目標を100%から下げた瞬間、その空白は塞ぐべき穴ではなく、計画的に使える資源になります。
2. Error Budget — 失敗を資源として扱う
目標を100%から下げると、その下に余白ができます。この余白を管理対象に昇格させたものが エラー予算(Error Budget)です。予算という名前なのは比喩ではなく、実際に予算のように扱うからです。総額が決まっていて、使えば減り、使い切れば行動が制約されます。
2.1 定義と計算
エラー予算は 100% − SLO です。定義はこの一行で終わりますが、実際に使うには何を単位として数えるかを先に決める必要があります。
時間基準(time-based)は可用性を観測時間の比率として見ます。SLO 99.9%で30日の窓なら予算は0.1%、つまり 43分12秒 です。ひと月のあいだにサービスが合計43分まで落ちても、目標は守ったことになります。1.1のダウンタイム表がそのまま予算表になるわけです。
リクエスト基準(request-based)は成功したリクエストの比率として見ます。同じSLOでひと月のトラフィックが1億リクエストなら、予算は 10万件 です。
この二つは同じSLOを別々に翻訳します。トラフィックが時間帯によって大きく上下するサービスなら、二つの値はかなり開きます。深夜3時に5分の障害が起きたとき、時間基準では5分をまるごと差し引きますが、リクエスト基準ではその時間帯の少ないリクエスト量の分だけ差し引かれます。ユーザー体験に近いのはリクエスト基準で、だからリクエスト/レスポンス型のサービスでは通常こちらを使います。逆にバッチパイプラインやインフラコンポーネントのようにリクエスト単位を定義しにくい対象には、時間基準が自然です。
重要なのは正解を選ぶことではなく、あらかじめ一つに合意しておくこと です。障害が起きたあとに有利な基準を選んだ瞬間、予算は意味を失います。
2.2 予算は使うものである
エラー予算で最も直感に反する部分がこれです。予算は残せば良いというものではありません。 DevOpsエンジニアとして、エラー予算を使って障害を許容するという表現は一般的には奇妙に聞こえるかもしれませんが、GoogleのSREでは違う定義をしています。
ひと月が終わって予算がほぼそのまま残っているなら、たいてい二つのうちどちらかです。目標を必要以上に保守的に設定したか、出せるものを出さずに控えたか。どちらも良い兆候ではありません。残った予算は翌月に繰り越されず、そのまま消えます。つまり 使わなかった分だけ機会を捨てた という意味になります。
だから予算は計画的に消費する対象になります。使いどころはおおよそ次のようなものです。
- リスクを引き受けたデプロイとカナリアリリース
- インフラ移行のように戻しにくい変更
- 本番でしか検証できない性能実験
- 意図的な障害訓練
GoogleのSRE本に印象的な事例が一つ出てきます。分散ロックサービスである Chubby は、SLOを大きく超える可用性を長く維持していました。問題は、そのせいで社内チームがChubbyは絶対に落ちないと仮定してシステムを設計し始めたという点です。SREチームの対応は信頼性をさらに上げることではなく、残った予算を消費するために 意図的にサービスを落とすこと でした。目標より過度に安定したサービスは、組織に誤った仮定を植え付けるという判断でした。
指標を目標としてだけ見ると理解できない決定です。予算として見れば自然な話になります。
2.3 予算が対立を解消する仕組み
1章で挙げた緊張に戻ってみましょう。開発チームはより速く出そうとし、SREは危険な変更を遅らせようとします。この対立が解けないのは、両者が互いに違う言語で話しているからです。一方は「この機能は今週出さなければならない」と言い、もう一方は「このデプロイは危険だ」と言います。この二つの文はそもそも比較できません。
エラー予算は二つの主張を同じ単位に変換します。議論はこう流れるようになります。
今月の予算は43分だ。これまでに12分使った。このデプロイの想定リスクが5分ぶんなら出してよい。
主観的なリスク感覚が 残高の照会 に変わります。そしてこのルールはデプロイを止める方向にだけ働くわけではありません。予算に余裕があれば、SRE側にはデプロイを止める根拠がなくなります。両方を拘束するからこそ、合意として成立するのです。
実務ではこれを エラー予算ポリシー(error budget policy)という文書として残します。最低限、次の項目が入ります。
- 予算が尽きたら何を止めるのか(通常は新機能デプロイの凍結)
- それでも出し続けられるものは何か(セキュリティパッチ、信頼性改善)
- 凍結を解除する条件は何か
- 例外を承認できるのは誰か
肝心なのは、この文書が 障害の前に合意されている という点です。エラー予算の本質は測定手法ではなく、事前に合意された意思決定ルールです。障害が起きたあとにルールを作ろうとすると、その場で最も切迫している人の声がルールになってしまいます。
2.4 burn rate — 残高より速度
予算を残高としてだけ見ていると対応が遅れます。43分のうち40分残っているという事実は、いまどれだけ速く漏れているのかを教えてくれません。だから実務で見る値は 消費速度(burn rate)です。
burn rateは、予算を窓全体に均等に使う場合を1として正規化した値です。1なら窓が終わる時点で予算をちょうど使い切ります。2なら半分の時点で使い切ります。SLO 99.9%でエラー率が1%ならburn rateは10であり、30日分の予算が3日で消えます。
この値が有用なのは、アラートの基準になり得るからです。静的なしきい値のアラート(「エラー率1%超過」)は、トラフィックの少ない時間帯には過敏に鳴り、多い時間帯には見逃します。burn rateは予算という分母で正規化されているので、ユーザー影響の大きさ に比例します。
GoogleのSREワークブックは、観測窓を複数重ねる方式を推奨しています。
| 消費量 | 観測窓 | burn rate | 該当エラー率 | この速度なら全額消費 | 対応 |
|---|---|---|---|---|---|
| 予算の2% | 1時間 | 14.4x | 1.44% | 約2日 | 即時呼び出し |
| 予算の5% | 6時間 | 6x | 0.60% | 5日 | 即時呼び出し |
| 予算の10% | 3日 | 1x | 0.10% | 30日 | チケット |
(SLO 99.9% / 30日の窓を基準)
短い窓は急性の障害を素早く捉え、長い窓はゆっくり漏れる問題を見逃しません。実際に構成するときは、短い窓と長い窓を ANDで束ねます。そうしないと、すでに復旧した障害のせいで長い窓のアラートがずっと後まで鳴り続けます。
1.1で、目標がなければすべての障害が同じように緊急になると書きました。burn rateはその問題の反対側にある答えです。同じエラー率でも、予算をどれだけ速く燃やしているかによって呼び出しとチケットに分かれます。アラートに優先順位が生まれるのです。
3. SLI — その数字は何を測っていたのか
ここまで99.9%という数字で予算を計算し、消費速度まで追いました。ところが肝心の、その99.9%が 何の 比率なのかは、まだ決めていません。
1.1のGitHubの表がこの空白をすでに見せていました。同じサービスなのにPackagesは100.0%で、Actionsは99.33%でした。「GitHubの可用性」という単一の数字は存在せず、何を測るかを決めたあとにようやく数字が出てきたのです。その「何」に当たるものが SLI です。
3.1 定義:SLOを測定可能にするもの
SLIは Service Level Indicator、実際に観測される定量指標です。良いSLIはほぼ例外なく次の形を取ります。
SLI = good events / valid events
比率にする理由は、トラフィック規模と無関係に比較できるからです。エラー件数をそのまま数えると、トラフィックが二倍に増えたとき指標も二倍悪く見えますが、ユーザーが受ける体験は変わっていないかもしれません。
定義で本当に難しいのは、good と valid を決める作業です。
good— 何を成功と見なすか。HTTP 200なら成功か、それとも500ms以内に届いた200だけが成功か。valid— 何を分母に入れるか。ボットトラフィック、ヘルスチェック、認証に失敗したリクエストは除外するか。
この二つの定義が、そのままSLOの意味を決めます。ここまで決まると、これまでの概念が一本の鎖としてつながります。
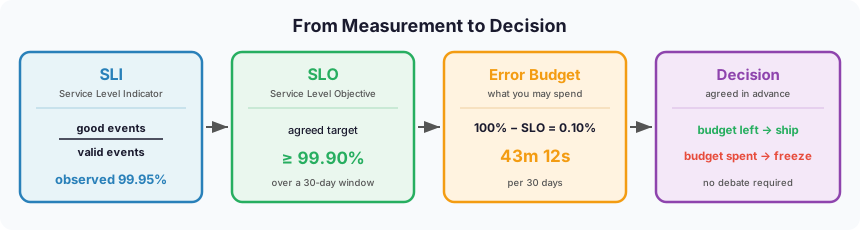
測定(SLI)が目標(SLO)を作り、目標が予算(Error Budget)を作り、予算が意思決定を作ります。この鎖の先頭が揺らげば、後ろのすべてが一緒に揺らぎます。
3.2 何を測るべきか
SLIとして使える指標は、いくつかの範疇に整理できます。
| 範疇 | 測るもの | 例 |
|---|---|---|
| 可用性 | リクエストは成功したか | 2xx・3xx レスポンスの比率 |
| レイテンシ | 十分に速かったか | 300ms以内のレスポンスの比率 |
| スループット | 必要なだけ処理したか | 秒あたりの処理件数 |
| 正確性 | 結果は正しいか | 誤って計算されたレコードの比率 |
| 鮮度 | データは最新か | 生成後10分以内に反映された比率 |
サービスの性格によって、重要な組み合わせが変わります。
- リクエスト/レスポンス型(API、Web)— 可用性とレイテンシが核心です。
- ストレージ — 可用性とレイテンシに耐久性が加わります。
- データパイプライン — 鮮度と正確性が中心です。こちらは可用性だけを見ても意味がありません。ジョブが成功し続けているのに6時間前のデータを出しているなら、ユーザーにとってそれは障害です。
3.3 平均は嘘をつく
レイテンシをSLIにするとき最も多い間違いは、平均を使うことです。
平均レスポンスタイム196msという値を見ると、おおむね妥当なサービスのように読めます。ところがその平均が次のような分布から出た値なら、話は変わってきます。
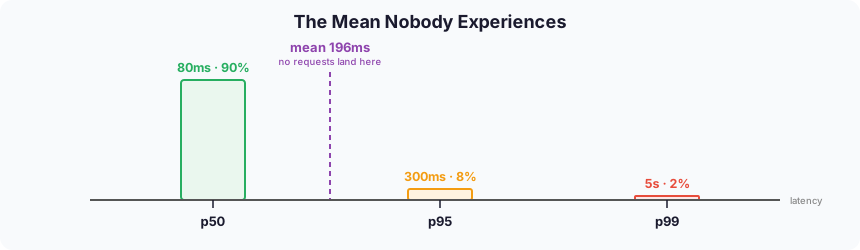
リクエストの90%は80msでレスポンスを受け取り、8%は300ms、2%は5秒待ちます。平均は196msと計算されますが、肝心の196ms付近でレスポンスを受け取ったリクエストは一つもありません。 平均は実際には存在しないユーザーを描写しているわけです。
同じ分布をパーセンタイルで見ると、隠れていたものが表に出てきます。p50は80ms、p95は300ms、そしてp99は5秒です。平均だけを見ていたチームとp99を見るチームは、同じサービスについてまったく違う判断をすることになります。だからレイテンシは分布として見るべきで、実務では パーセンタイル(p50・p95・p99)を使います。
そして裾にいるその2%が、よりによって重要なユーザーである可能性が高いのです。データの多いアカウント、長く使っているアカウント、規模の大きい組織であるほどクエリは重くなり、レスポンスは遅くなります。平均だけを見るチームは、最も高価な顧客が抱えている問題を構造的に見られません。
測定地点も併せて見る必要があります。ロードバランサーで測った成功率には二つの罠があります。
- クライアントでしか見えない失敗が抜け落ちます。 200を返したのに画面が空だった場合、レスポンスが遅すぎてユーザーが離れた場合は、サーバー側の指標には成功として残ります。
- ロードバランサーが落ちれば、何の記録も残りません。 指標が静かなことと問題がないことは違います。
1.2で、ユーザー区間はほとんどが自分の制御の外だと書きました。その区間の失敗まで測るには、クライアント側の観測が必要です。ただしここには実装と運用のコストが付くので、何をどこで測るのがこのサービスにとって妥当なのかは、それ自体が別の判断になります。
3.4 SLIは少ないほど良い
観測ツールを入れると数百の指標が付いてきます。このとき湧く誘惑は可能な限り多くの指標をSLIに昇格させることですが、方向は逆であるべきです。
SLIは ユーザー体験に直結する少数だけ を選びます。サービスあたり3つから5つで十分だというのが一般的な推奨です。指標が増えると、ある指標が悪化したときに何をすべきかが曖昧になり、結局どの指標も意思決定に使われなくなります。
CPU使用率はSLIではありません。数えられるしダッシュボードにもよく映えますが、CPUが80%だという事実は、ユーザーがいま何を体験しているのかを教えてくれません。それは 原因側の指標 であり、アラートではなくデバッグに使われるべきものです。
基準は二つの文に整理できます。この指標が悪化するとユーザーが不便になるか。 そして この指標が悪化したときに我々が取る行動が決まっているか。 どちらか一方でも否なら、それはSLIではなく単なるメトリクスです。
4. 余談:SLAはただの契約である
SLAは Service Level Agreement、外部の顧客と結ぶ契約です。前の三つの概念と決定的に違う点は、違反に金銭的な結果が伴う ということです。多くのクラウドサービスが月間可用性を約束し、その値に届かなければ料金の一部をクレジットとして返します。
だからSLAはエンジニアリングのツールというより、法務と営業のツールに近いものです。SLI・SLO・エラー予算が「どう運用するか」に答えるなら、SLAは「守れなかったとき何を賠償するか」に答えます。
ここから実務的に重要なルールが一つ導かれます。SLOはSLAより必ず厳しくなければなりません。 顧客と99.9%を約束したなら、内部目標は99.95%のような値であるべきです。そうしてはじめて、内部アラートが契約違反より先に鳴ります。SLOとSLAを同じ値にすると、アラートが鳴る瞬間がすでに賠償が発生した瞬間になってしまいます。
四つの概念を一度に整理すると、次のようになります。
| 概念 | 何なのか | 誰との約束か | 破ったとき |
|---|---|---|---|
| SLI | 実際に観測した値 | —(測定) | 該当なし |
| SLO | 内部で合意した目標 | チーム間の合意 | デプロイ凍結などの内部ポリシー発動 |
| Error Budget | 目標と100%のあいだの余裕 | チーム間の合意 | 尽きた時点でポリシー発動 |
| SLA | 顧客と結んだ契約 | 外部の顧客 | 料金クレジットなどの金銭的賠償 |
ほとんどの組織で毎日覗くのは上の三行です。SLAは、その三行がきちんと回っているときに自然と守られる結果に近いものです。
5. インフラチームが指標でサービスを運用すべき理由
これまで話してきたサービスレベルに関する様々な指標とエラー予算を踏まえると、組織の中でインフラチームができることが定まってきます。SLOをどう設定するかによって、インフラ組織が担うべき仕事が決まるのです。
5.1 判断を人からルールへ移す
障害が発生したとき素早く対応すべきだということは、誰でも知っている事実です。そして、たとえばマイクロサービス構成で決済サーバーと相対的に致命度の低いバックオフィスサーバーに同時に障害が発生したなら、どちらのサーバーを先に対応すべきかは誰でも直感的に分かるでしょう。
ただ、こうした直感ではなくSLOを基準にして説明するようになると、決済サーバーとバックオフィスサーバーがそれぞれどれくらいの可用性を保証すべきで、残ったエラー予算がどれくらいで、どれくらいのダウンタイムを許容するのかを測定できるようになります。
直感が問題になるのは、サービスが二つのときではなく三十になったときです。決済とバックオフィスなら誰でも優先順位が分かります。ところがアラートが同時に五つ鳴り、そのうち三つは名前を見ただけでは重要度が分からない内部サービスで、当番がそのサービスを作った人でないなら、直感は機能しません。SLOはその判断を文書に移して、誰が当番でも同じ結論に到達できるようにします。
5.2 信頼性を「要求事項」にする
インフラチームがよく直面する状況があります。冗長化が必要だと言っても、次の四半期のロードマップで押し出されてしまう。信頼性の作業には目に見える成果物がなく、機能にはあるからです。
問題は論理より言語にあります。「この構成は危険だ」という文は、優先順位の競争で勝つのが難しいのです。一方、次のような文は性格が違います。
決済APIのSLOは99.9%で、直近二四半期連続でエラー予算を超過した。ポリシーに従い、今四半期は新機能のデプロイを凍結する。
同じ主張が 合意された要求事項 に変わります。信頼性の作業が、インフラチームの希望からポリシー上やるべきことになる瞬間です。
プロビジョニング規模を決めるときも同じ構造が働きます。冒頭で どれだけ備えれば十分なのか という問いを出しましたが、この問いにはそれ自体では答えがありません。目標可用性が定まってはじめて、必要な冗長化の水準、リージョン構成、余裕容量が計算可能な値になります。インフラチームにSLOが必要な最も実務的な理由がこれです。どれだけ備えるかは、どこまで失敗を許容するかから導かれます。
5.3 アラートが意味を取り戻す
アラートが多くなると、アラートを信じなくなります。深夜に鳴ったアラート十個のうち九個が何の対応も必要なかったなら、十個目も同じ扱いを受けます。
この問題の原因は、たいていアラートが 原因 に紐づいているという点です。CPU 80%、ディスク使用率90%、メモリのしきい値 — どれも数えられるし、しきい値を決めるのも簡単ですが、ユーザーがいま不便かどうかとは直接つながりません。CPUが80%でもレスポンスタイムが正常なら、ユーザーには何も起きていないのと同じです。
SLOベースのアラートは反対の方向から近づきます。ユーザー影響があるときだけ 鳴るのです。そして2.4で見たburn rateが、ここで強度まで決めてくれます。予算を速く燃やしているなら呼び出し、ゆっくり漏れているならチケットです。
ここで得られるのは、アラートの数が減ること自体ではありません。残ったアラートを信頼できるようになること です。鳴ったなら実際にユーザーが体験しているという意味なので、深夜に起きる理由が生まれます。
5.4 始め方
完璧なSLO体系を先に設計しようとすると、始められません。すべてのサービスに指標を付けて全社の合意を得る作業は数四半期かかるプロジェクトで、たいてい途中で止まります。
現実的な順序はこうです。
- ユーザージャーニーを一つ選びます。 このサービスで最も重要な流れ一つで十分です。決済、ログイン、検索のどれか。
- SLIを一つ定義します。
goodとvalidを決める作業です。ここに時間を使うべきです。 - 目標なしでまず観測します。 数週間、ただ測ります。現在の水準を知らない状態で決めた目標は、たいてい間違っています。
- 観測値を根拠にSLOを決めます。 現在の水準より少し低いところから始めるほうが良いです。達成不可能な目標はポリシー自体を無力化します。
- エラー予算ポリシーに合意します。 2.3の四項目で十分です。文書一枚から始めます。
- 四半期ごとに見直します。 予算が毎回残るなら目標を上げ、毎回破綻するなら目標が現実に合っていないか、信頼性の作業が足りていないということです。
GoogleのSREワークブックには、この過程にそのまま使える例文書が付録として付いています。Appendix A がSLO文書の例で、Appendix B がエラー予算ポリシーの例です。最初に作るとき、白紙から始めなくて済みます。
おわりに
この記事は どれだけ備えれば十分なのか という問いから始まりました。書きながら確認したのは、その問いが単独では答えの出ない問いだったという事実です。どこまで失敗を許容するかを決めなければ、どれだけ備えるべきかも決められません。SLOはその順序を正す装置でした。
三つの概念を改めて整理すると、こう読めます。SLIは何を見るかを決める作業であり、SLOはどこまでが大丈夫かを合意する作業であり、エラー予算はその合意を毎日の意思決定につなげる作業です。だからこれらは測定ツールではなく、失敗をあらかじめ合意しておく方法 に近いものです。障害が起きたあとに何をするか決める組織と、起きる前に決めておいた組織の差は、対応の速さではなく対応の一貫性に表れます。
100%を目標にしないことは、怠慢のように感じられるかもしれません。しかし1.2の掛け算構造を一度見てしまうと、考えが変わります。100%は野心の大きな目標ではなく、そもそも到達できない座標であり、それを目標として宣言した瞬間、組織は失敗を扱う言語を失います。失敗の総量をあらかじめ決めておくほうが、はるかに工学的な態度です。
最初にこれらの概念を調べたときに物足りなかったのは、定義が難しかったからではありません。SLOが何かは一行で読めました。足りなかったのは その定義がなぜ必要だったのか でした。100%が不可能だという事実から出発してエラー予算まで追っていくと、三つの概念にそれぞれ存在する理由が生まれます。定義を覚えることと、その定義が必要になった文脈を知ることの差が、この記事を書きながら最も大きく残った部分です。
References
GoogleのSRE三部作
三冊すべて全文が無料で公開されています。(sre.google/books)
| 書籍 | 原文 |
|---|---|
| Site Reliability Engineering (2016) | 目次 |
| The Site Reliability Workbook (2018) | 目次 |
| Building Secure & Reliable Systems (2020) | 目次 |
この記事で直接参照した章
| 出典 | 章 |
|---|---|
| SRE Book | 第3章 Embracing Risk |
| SRE Book | 第4章 Service Level Objectives |
| SRE Book | 第6章 Monitoring Distributed Systems |
| SRE Book | 第10章 Practical Alerting |
| Workbook | 第1章 How SRE Relates to DevOps |
| Workbook | 第2章 Implementing SLOs |
| Workbook | 第3章 SLO Engineering Case Studies |
| Workbook | 第5章 Alerting on SLOs |
| Workbook | 第16章 Canarying Releases |
| Workbook | Appendix A. Example SLO Document |
| Workbook | Appendix B. Example Error Budget Policy |
データ出典
- GitHub Status — 1.1のコンポーネント別90日uptime。2026年8月21日時点の取得で、90日ローリングウィンドウのため現在の値は異なります。