그동안 DevOps 엔지니어로 일하면서 SLO나 SLA라는 말은 자주 접했다. 다만 자세히 들여다본 적은 없었다. 찾아보는 글들도 대부분 용어를 한 줄로 정리하는 수준에서 그쳤기 때문에, 본격적으로 이해할 계기를 만들기가 쉽지 않았다.
최근에 시간을 내어 구글의 Site Reliability Engineering을 읽었는데, 이 책은 SLO를 다루는 방식이 달랐다. 정의를 나열하는 대신 “100% 가용성은 목표가 될 수 없다”는 명제에서 출발한다. 그리고 목표를 100%에서 내렸을 때 생기는 빈 공간을 Error Budget이라 부르며, 배포 속도와 안정성 사이의 결정을 그 예산에 맡긴다. 지표가 아니라 의사결정 장치로 읽히는 순간이었다.
마침 회사에서도 KPI를 산정하면서 SLO 같은 합의의 영역을 들여다보게 되었고, 적절한 인프라 프로비저닝의 기준을 고민하다 보니 결국 같은 자리로 돌아왔다. 얼마를 준비해야 충분한가는 얼마까지 실패를 허용할 것인가를 정하지 않으면 답이 나오지 않는 질문이었다.
이 글은 그 질문을 따라간 기록이다. SLO에서 시작해 100%가 불가능한 이유를 지나 Error Budget으로, 그다음 그 숫자가 애초에 무엇을 재고 있었는지(SLI)로, 마지막으로 SLA와 인프라 팀의 운영 방식까지 이어진다.
1. SLO란 무엇인가
SLO는 Service Level Objective의 앞 글자를 딴 말이다. 서비스가 달성하려는 신뢰성의 목표값을 뜻한다. 다만 핵심은 목표라는 단어가 아니라 합의라는 점에 있다.
구글 SRE 책은 이 합의가 필요한 이유를 조직 간의 구조적 긴장에서 찾는다. 제품 개발팀은 새 기능을 빠르게 내보내는 것으로 평가받는다. 반면 SRE 팀은 서비스가 죽지 않는 것으로 평가받는다. 그런데 배포는 변경이고, 변경은 장애의 가장 흔한 원인이다. 그래서 한쪽은 더 빠르게 내보내려 하고, 다른 쪽은 위험한 변경을 늦추려 한다. 두 입장이 모두 정당하기 때문에, 이 대립은 누가 옳은지를 따져서는 끝나지 않는다.
SLO는 이 논쟁을 숫자에 대한 합의로 바꾼다. 예를 들어 가용성 99.9%를 SLO로 정했다면, 남은 0.1%는 신뢰성을 조금 내주더라도 더 빠른 배포와 실험에 쓸 수 있는 몫이 된다. 이 몫에 이름을 붙인 것이 에러 예산(Error Budget)이다.
1.1 목표가 없으면 판단도 없다
신뢰성은 정상이냐 장애냐의 이진값이 아니라 연속적인 값이다.
최근 GitHub 장애가 잦아지면서 개발 커뮤니티에서 서비스를 옮길지 말지에 대한 이야기가 오갔다. GitHub은 상태 페이지에서 지난 90일간의 uptime을 공개한다.
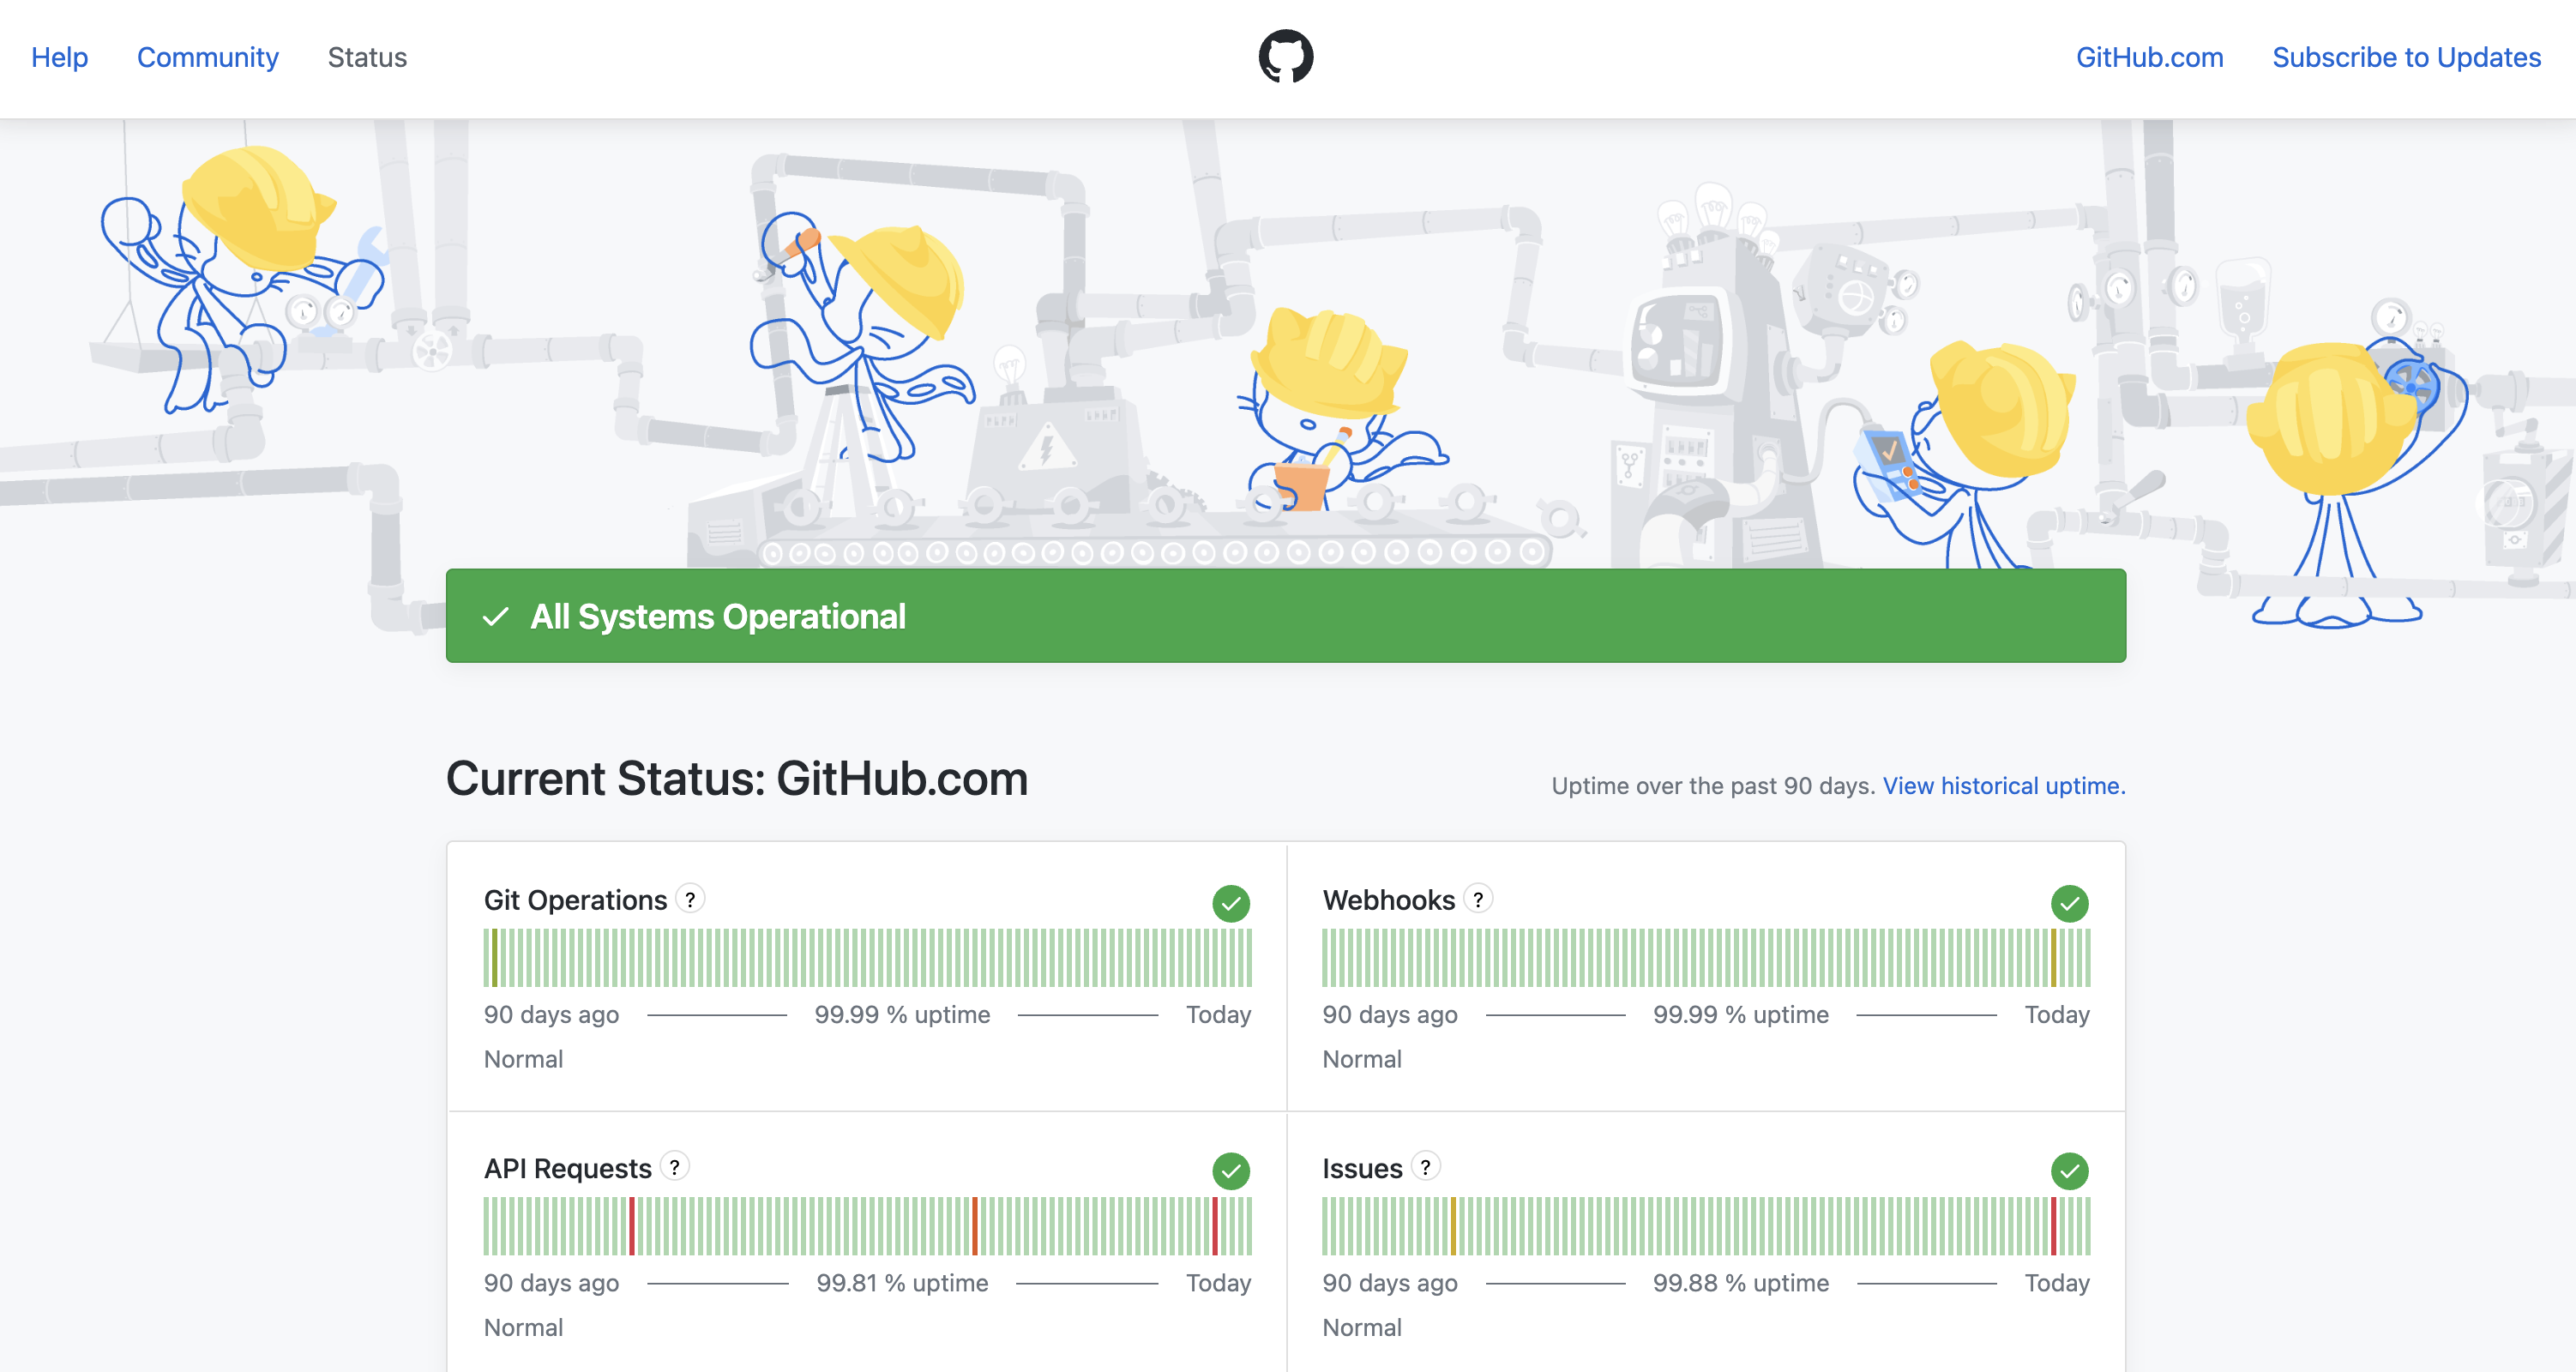
이 화면에서 눈길이 가는 건 상단 배너가 All Systems Operational을 가리키고 있는데도, 아래 막대에는 장애의 흔적이 색으로 남아 있다는 점이다. 지금 이 순간은 정상이지만, 90일이라는 창으로 보면 이 서비스는 여러 번 흔들렸다. 지금 살아 있는가와 얼마나 신뢰할 수 있는가는 다른 질문이고, 뒤쪽 질문은 이진값으로 답할 수 없다.
컴포넌트별로 숫자가 갈리는 것도 흥미롭다.
| 컴포넌트 | 90일 uptime |
|---|---|
| Packages | 100.0% |
| Git Operations | 99.99% |
| Webhooks | 99.99% |
| Codespaces | 99.97% |
| Issues / Pull Requests | 99.88% |
| API Requests | 99.81% |
| Pages | 99.65% |
| Copilot | 99.64% |
| Actions | 99.33% |
(2026년 8월 21일 기준, 90일 롤링 윈도우)
같은 GitHub인데 Packages는 100.0%이고 Actions는 99.33%다. “GitHub은 안정적인가"라는 질문에 하나의 숫자로 답할 수 없다는 뜻이다. 무엇을 재느냐에 따라 답이 달라지는데, 이 문제는 뒤의 SLI에서 다시 다룬다.
그리고 이 소수점들은 생각보다 큰 차이를 만든다. 백분율은 직관을 속이기 때문에, 허용 다운타임으로 환산해 보면 감이 달라진다.
| SLO | 월 (30일) | 주 | 일 |
|---|---|---|---|
| 99% | 7시간 12분 | 1시간 41분 | 14분 24초 |
| 99.9% | 43분 12초 | 10분 5초 | 1분 26초 |
| 99.95% | 21분 36초 | 5분 2초 | 43초 |
| 99.99% | 4분 19초 | 1분 1초 | 8.6초 |
| 99.999% | 26초 | 6초 | 0.9초 |
앞의 표에서 Actions의 99.33%는 90일 기준으로 약 14시간 30분의 다운타임에 해당한다. 99.9%와 99.99% 사이의 거리도 한 달에 43분과 4분이라는, 대응 방식이 완전히 달라지는 간격이다.
목표가 정해져 있지 않으면 알림이 울렸을 때 대응할 일인지 넘길 일인지 판단할 근거가 없다. 그러면 모든 장애가 똑같이 긴급해지고, 우선순위는 결국 그 자리에서 목소리가 큰 사람 순으로 정해진다. SLO를 정하는 일은 그 판단선을 미리 그어두는 일이다.
1.2 SLO는 ‘높을수록 좋은 값’이 아니다
높은 가용성을 제공하는 것은 보통 미덕으로 여겨진다. 하지만 목표를 산정하는 입장에서 보면, 숫자를 올리는 것이 항상 좋은 선택은 아니다.
사용자의 요청이 내 서버에 닿기까지는 여러 인프라를 거친다. 집의 전기와 공유기, ISP 회선, DNS, 인터넷 백본을 지나서야 내 인프라에 도착한다. 이 구간들은 각각 100%가 아니고, 대부분 내가 손댈 수 없는 영역이다.
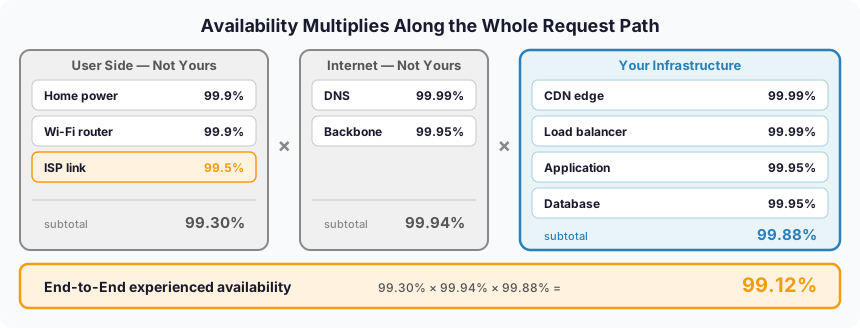
가용성은 더해지지 않고 곱해진다. 위 예시에서 내 인프라는 99.88%지만, 사용자 구간(99.30%)과 인터넷 구간(99.94%)을 함께 통과한 결과는 99.12%다. 내가 통제하는 구간이 사슬에서 가장 튼튼한데도, 전체 숫자를 끌어내리는 것은 내가 손댈 수 없는 쪽이다.
여기서 따라오는 결론이 있다. 내 인프라의 네 요소를 모두 99.999%까지 끌어올려도 전체 체감 가용성은 99.12%에서 99.24%로 올라간다. 연간 다운타임으로는 약 4,612분에서 4,007분, 열 시간 정도 줄어드는 셈이다. 그 열 시간을 위해 멀티 리전과 멀티 클라우드를 감당할 가치가 있는지는 완전히 별개의 질문이다.
사용자가 체감하지 못하는 신뢰성에는 값을 지불할 이유가 없다. SLO를 정할 때 “가능한 한 높게"가 답이 되지 못하는 이유가 여기에 있다.
1.3 그래서 100%는 목표가 될 수 없다
1.2에서 본 곱셈 구조가 첫 번째 이유다. 내 서비스의 가용성은 내가 의존하는 모든 것의 곱보다 클 수 없고, 그 사슬에는 전기와 회선처럼 내가 계약조차 하지 않은 항목이 섞여 있다. 100%를 주장하려면 그 모든 계층이 100%여야 한다.
두 번째는 비용이다. 9를 하나 더 붙이는 비용은 선형으로 늘지 않는다. 단일 인스턴스에서 이중화로, 이중화에서 멀티 AZ로, 다시 멀티 리전과 멀티 클라우드로 넘어갈 때마다 필요한 것은 장비만이 아니라 그것을 설계하고 검증하고 운영할 사람의 시간이다. 그 시간은 기능을 만들지 못한 시간이기도 하다.
세 번째는 조직이다. 100%를 목표로 선언하면 모든 실패가 ‘있어서는 안 될 일’이 된다. 그러면 실패를 학습으로 바꾸는 회고 대신 책임을 찾는 회의가 열리고, 변경 자체가 위험으로 취급되어 배포가 멈춘다. 실패 허용량을 명시하지 않은 조직은 실패에서 배우지 못한다.
그래서 발상을 뒤집는다. 얼마나 죽지 않을 것인가를 묻는 대신 얼마나 죽어도 괜찮은가를 정한다. 목표를 100%에서 내리는 순간, 그 빈 공간은 막아야 할 구멍이 아니라 계획적으로 쓸 수 있는 자원이 된다.
2. Error Budget — 실패를 자원으로 다루기
목표를 100%에서 내리면 그 아래에 여백이 생긴다. 이 여백을 관리 대상으로 승격시킨 것이 에러 예산(Error Budget)이다. 이름이 예산인 이유는 은유가 아니라 실제로 예산처럼 다루기 때문이다. 총액이 정해져 있고, 쓰면 줄어들고, 다 쓰면 행동이 제약된다.
2.1 정의와 계산
에러 예산은 100% − SLO다. 정의는 이 한 줄로 끝나지만, 실제로 쓰려면 무엇을 단위로 셀지를 먼저 정해야 한다.
시간 기준(time-based)은 가용성을 관측 시간의 비율로 본다. SLO 99.9%에 30일 창이라면 예산은 0.1%, 즉 43분 12초다. 한 달 동안 서비스가 총 43분까지는 죽어도 목표를 지킨 것이 된다. 1.1의 다운타임 표가 그대로 예산표가 되는 셈이다.
요청 기준(request-based)은 성공한 요청의 비율로 본다. 같은 SLO에서 한 달 트래픽이 1억 요청이라면 예산은 10만 건이다.
둘은 같은 SLO를 서로 다르게 번역한다. 트래픽이 시간대별로 크게 출렁이는 서비스라면 두 값이 꽤 벌어진다. 새벽 3시에 5분짜리 장애가 났을 때, 시간 기준으로는 5분을 통째로 차감하지만 요청 기준으로는 그 시간대의 적은 요청량만큼만 차감된다. 사용자 경험에 더 가까운 쪽은 요청 기준이고, 그래서 요청/응답형 서비스에서는 보통 이쪽을 쓴다. 반대로 배치 파이프라인이나 인프라 컴포넌트처럼 요청 단위를 정의하기 어려운 대상에는 시간 기준이 자연스럽다.
중요한 것은 정답을 고르는 일이 아니라 미리 하나로 합의하는 일이다. 장애가 난 다음에 유리한 기준을 고르는 순간 예산은 의미를 잃는다.
2.2 예산은 쓰는 것이다
에러 예산에서 가장 반직관적인 부분은 이것이다. 예산은 남기면 좋은 것이 아니다. 데브옵스 엔지니어로서 에러 예산을 써서 장애를 허용한다는 표현이 일반적으로 이상하게 들릴 수 있겠지만 구글 SRE에서는 다르게 정의한다.
한 달이 끝났는데 예산이 거의 그대로 남아 있다면 보통 두 가지 중 하나다. 목표를 필요 이상으로 보수적으로 잡았거나, 낼 수 있는 것을 내지 않고 아꼈거나. 둘 다 좋은 신호가 아니다. 남은 예산은 다음 달로 이월되지 않고 그냥 사라지는데, 그 말은 쓰지 않은 만큼 기회를 버렸다는 뜻이다.
그래서 예산은 계획적으로 소비할 대상이 된다. 쓰는 곳은 대체로 이렇다.
- 위험을 감수한 배포와 카나리 릴리스
- 인프라 마이그레이션처럼 되돌리기 어려운 변경
- 프로덕션에서만 검증되는 성능 실험
- 의도적인 장애 훈련
구글 SRE 책에 인상적인 사례가 하나 나온다. 분산 락 서비스인 Chubby는 SLO를 한참 초과하는 가용성을 오래 유지했다. 문제는 그러다 보니 내부 팀들이 Chubby가 절대 죽지 않는다고 가정한 채 시스템을 설계하기 시작했다는 점이다. SRE 팀의 대응은 신뢰성을 더 올리는 것이 아니라, 남은 예산을 소비하기 위해 의도적으로 서비스를 내리는 것이었다. 목표보다 과도하게 안정적인 서비스는 조직에 잘못된 가정을 심는다는 판단이었다.
지표를 목표로만 보면 이해되지 않는 결정이다. 예산으로 보면 자연스럽다.
2.3 예산이 갈등을 해소하는 방식
1장에서 꺼낸 긴장으로 돌아가 보자. 개발팀은 더 빠르게 내보내려 하고, SRE는 위험한 변경을 늦추려 한다. 이 대립이 풀리지 않는 이유는 양쪽이 서로 다른 언어로 말하기 때문이다. 한쪽은 “이 기능은 이번 주에 나가야 한다"고 말하고 다른 쪽은 “이 배포는 위험하다"고 말한다. 두 문장은 비교 자체가 불가능하다.
에러 예산은 두 주장을 같은 단위로 바꾼다. 논의는 이제 이렇게 흘러간다.
이번 달 예산은 43분이다. 지금까지 12분을 썼다. 이 배포의 예상 위험이 5분어치라면 나가도 된다.
주관적인 위험 감각이 잔액 조회로 바뀐다. 그리고 이 규칙은 배포를 막는 방향으로만 작동하지 않는다. 예산이 넉넉하면 SRE 쪽에서 배포를 막을 근거가 사라진다. 양쪽을 모두 구속하기 때문에 합의로 성립한다.
실무에서는 이것을 에러 예산 정책(error budget policy)이라는 문서로 남긴다. 최소한 다음이 들어간다.
- 예산이 소진되면 무엇을 멈추는가 (보통 신규 기능 배포 동결)
- 그래도 계속 나갈 수 있는 것은 무엇인가 (보안 패치, 신뢰성 개선)
- 동결을 해제하는 조건은 무엇인가
- 예외를 승인할 수 있는 사람은 누구인가
핵심은 이 문서가 장애 전에 합의되어야 한다는 점이다. 에러 예산의 본질은 측정 기법이 아니라 사전에 합의된 의사결정 규칙이다. 장애가 터진 다음에 규칙을 만들려 하면, 그 자리에서 가장 다급한 사람의 목소리가 규칙이 된다.
2.4 burn rate — 잔액보다 속도
예산을 잔액으로만 보면 대응이 늦는다. 43분 중 40분이 남아 있다는 사실은 지금 얼마나 빠르게 새고 있는지를 알려주지 않는다. 그래서 실무에서 보는 값은 소진 속도(burn rate)다.
burn rate는 예산을 창 전체에 균등하게 쓰는 경우를 1로 두고 정규화한 값이다. 1이면 창이 끝나는 시점에 예산을 정확히 다 쓴다. 2면 절반 시점에 소진한다. SLO 99.9%에서 오류율이 1%라면 burn rate는 10이고, 30일치 예산이 3일에 사라진다.
이 값이 유용한 이유는 알림의 기준이 될 수 있기 때문이다. 정적 임계값 알림(“오류율 1% 초과”)은 트래픽이 적은 시간대에는 과민하게 울리고 많은 시간대에는 놓친다. burn rate는 예산이라는 분모로 정규화되어 있어서 사용자 영향의 크기에 비례한다.
구글 SRE 워크북은 관측 창을 여러 개 겹쳐 쓰는 방식을 권한다.
| 소진량 | 관측 창 | burn rate | 해당 오류율 | 이 속도면 전액 소진 | 대응 |
|---|---|---|---|---|---|
| 예산의 2% | 1시간 | 14.4x | 1.44% | 약 2일 | 즉시 호출 |
| 예산의 5% | 6시간 | 6x | 0.60% | 5일 | 즉시 호출 |
| 예산의 10% | 3일 | 1x | 0.10% | 30일 | 티켓 |
(SLO 99.9% / 30일 창 기준)
짧은 창은 급성 장애를 빠르게 잡고, 긴 창은 천천히 새는 문제를 놓치지 않는다. 실제로 구성할 때는 짧은 창과 긴 창을 AND로 묶는다. 그러지 않으면 이미 복구된 장애 때문에 긴 창의 알림이 한참 뒤까지 계속 울린다.
1.1에서 목표가 없으면 모든 장애가 똑같이 긴급해진다고 했다. burn rate는 그 문제의 반대편에 있는 답이다. 같은 오류율이라도 예산을 얼마나 빠르게 태우고 있는지에 따라 호출과 티켓으로 갈린다. 알림에 우선순위가 생긴다.
3. SLI — 그 숫자는 무엇을 재고 있었나
여기까지 99.9%라는 숫자로 예산을 계산하고 소진 속도까지 따졌다. 그런데 정작 그 99.9%가 무엇의 비율인지는 아직 정하지 않았다.
1.1의 GitHub 표가 이 공백을 이미 보여줬다. 같은 서비스인데 Packages는 100.0%였고 Actions는 99.33%였다. “GitHub의 가용성"이라는 단일한 숫자는 존재하지 않았고, 무엇을 재는지 정한 다음에야 숫자가 나왔다. 그 ‘무엇’에 해당하는 것이 SLI다.
3.1 정의: SLO를 측정 가능하게 만드는 것
SLI는 Service Level Indicator, 실제로 관측되는 정량 지표다. 좋은 SLI는 거의 예외 없이 다음 형태를 띤다.
SLI = good events / valid events
비율로 두는 이유는 트래픽 규모와 무관하게 비교할 수 있기 때문이다. 오류 건수를 그대로 세면 트래픽이 두 배로 늘 때 지표도 두 배로 나빠 보이지만, 사용자가 겪는 경험은 그대로일 수 있다.
정의에서 진짜 어려운 부분은 good과 valid를 정하는 일이다.
good— 무엇을 성공으로 볼 것인가. HTTP 200이면 성공인가, 아니면 500ms 안에 도착한 200만 성공인가.valid— 무엇을 분모에 넣을 것인가. 봇 트래픽, 헬스체크, 인증에 실패한 요청은 제외할 것인가.
이 두 정의가 곧 SLO의 의미를 결정한다. 여기까지 정하면 앞의 개념들이 하나의 사슬로 이어진다.
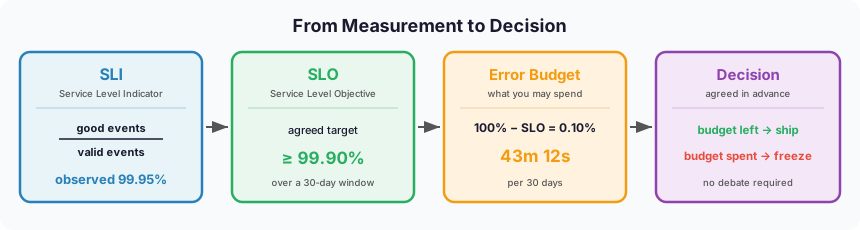
측정(SLI)이 목표(SLO)를 만들고, 목표가 예산(Error Budget)을 만들고, 예산이 의사결정을 만든다. 이 사슬의 맨 앞이 흔들리면 뒤의 모든 것이 함께 흔들린다.
3.2 무엇을 재야 하는가
SLI로 쓸 수 있는 지표는 몇 가지 범주로 정리된다.
| 범주 | 재는 것 | 예시 |
|---|---|---|
| 가용성 | 요청이 성공했는가 | 2xx·3xx 응답의 비율 |
| 지연시간 | 충분히 빨랐는가 | 300ms 이내 응답의 비율 |
| 처리량 | 필요한 만큼 처리했는가 | 초당 처리 건수 |
| 정확성 | 결과가 올바른가 | 잘못 계산된 레코드의 비율 |
| 신선도 | 데이터가 최신인가 | 생성 후 10분 이내 반영된 비율 |
서비스 성격에 따라 중요한 조합이 달라진다.
- 요청/응답형 (API, 웹) — 가용성과 지연시간이 핵심이다.
- 스토리지 — 가용성과 지연시간에 내구성이 더해진다.
- 데이터 파이프라인 — 신선도와 정확성이 중심이다. 이쪽은 가용성만 봐서는 의미가 없다. 잡이 계속 성공하는데 6시간 전 데이터를 내보내고 있다면, 사용자에게는 그것이 장애다.
3.3 평균은 거짓말을 한다
지연시간을 SLI로 삼을 때 가장 자주 하는 실수는 평균을 쓰는 것이다.
평균 응답시간 196ms라는 값을 보면 대체로 준수한 서비스처럼 읽힌다. 그런데 그 평균이 아래와 같은 분포에서 나온 값이라면 이야기가 달라진다.
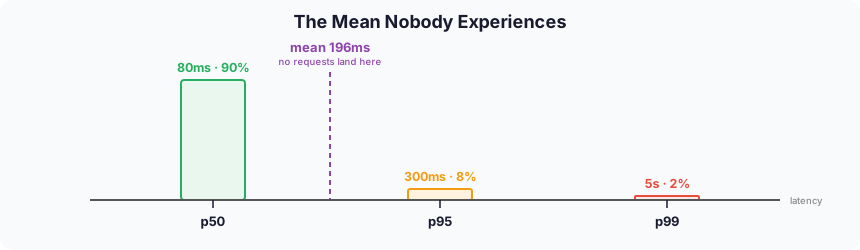
요청의 90%는 80ms에 응답을 받고, 8%는 300ms, 2%는 5초를 기다린다. 평균은 196ms로 계산되지만 정작 196ms 근처에서 응답을 받은 요청은 하나도 없다. 평균은 실제로 존재하지 않는 사용자를 묘사하고 있는 셈이다.
같은 분포를 백분위로 보면 숨어 있던 것이 드러난다. p50은 80ms, p95는 300ms, 그리고 p99는 5초다. 평균만 보던 팀과 p99를 보는 팀은 같은 서비스를 두고 완전히 다른 판단을 하게 된다. 그래서 지연시간은 분포로 봐야 하고, 실무에서는 백분위(p50 · p95 · p99)를 쓴다.
그리고 꼬리에 있는 그 2%가 하필 중요한 사용자일 가능성이 높다. 데이터가 많은 계정, 오래 쓴 계정, 규모가 큰 조직일수록 쿼리가 무거워지고 응답이 느려진다. 평균만 보는 팀은 가장 비싼 고객이 겪는 문제를 구조적으로 보지 못한다.
측정 지점도 함께 봐야 한다. 로드밸런서에서 잰 성공률에는 두 가지 함정이 있다.
- 클라이언트에서만 보이는 실패가 빠진다. 200을 반환했지만 화면이 비어 있는 경우, 응답이 너무 느려 사용자가 떠난 경우는 서버 지표에 성공으로 남는다.
- 로드밸런서가 죽으면 아무 기록도 남지 않는다. 지표가 조용한 것과 문제가 없는 것은 다르다.
1.2에서 사용자 구간은 대부분 내 통제 밖이라고 했다. 그 구간의 실패까지 재려면 클라이언트 측 관측이 필요하다. 다만 여기에는 구현과 운영 비용이 붙기 때문에, 무엇을 어디서 재는 것이 이 서비스에 합당한지는 별도의 판단이다.
3.4 SLI는 적을수록 좋다
관측 도구를 붙이면 수백 개의 지표가 따라온다. 이때 드는 유혹은 가능한 많은 지표를 SLI로 승격시키는 것이지만, 방향은 반대여야 한다.
SLI는 사용자 경험과 직결된 소수만 고른다. 서비스당 세 개에서 다섯 개면 충분하다는 것이 일반적인 권고다. 지표가 많아지면 어떤 지표가 나빠졌을 때 무엇을 해야 하는지가 흐려지고, 결국 어느 지표도 의사결정에 쓰이지 않는다.
CPU 사용률은 SLI가 아니다. 셀 수 있고 대시보드에 잘 어울리지만, CPU가 80%라는 사실은 사용자가 지금 무엇을 겪고 있는지 알려주지 않는다. 그것은 원인 쪽 지표이고, 알림이 아니라 디버깅에 쓰여야 한다.
기준은 두 문장으로 정리된다. 이 지표가 나빠지면 사용자가 불편해지는가. 그리고 이 지표가 나빠졌을 때 우리가 할 행동이 정해져 있는가. 둘 중 하나라도 아니라면 그것은 SLI가 아니라 그냥 메트릭이다.
4. 곁다리: SLA는 그냥 계약이다
SLA는 Service Level Agreement, 외부 고객과 맺는 계약이다. 앞의 세 개념과 결정적으로 다른 점은 위반에 금전적 결과가 붙는다는 것이다. 많은 클라우드 서비스가 월간 가용성을 약속하고, 그 값에 미달하면 요금의 일부를 크레딧으로 돌려준다.
그래서 SLA는 엔지니어링 도구라기보다 법무와 영업의 도구에 가깝다. SLI·SLO·에러 예산이 “어떻게 운영할까"에 답한다면, SLA는 “못 지켰을 때 무엇을 배상할까"에 답한다.
여기서 실무적으로 중요한 규칙 하나가 따라온다. SLO는 SLA보다 반드시 엄격해야 한다. 고객과 99.9%를 약속했다면 내부 목표는 99.95% 같은 값이어야 한다. 그래야 내부 알림이 계약 위반보다 먼저 울린다. SLO와 SLA를 같은 값으로 두면, 알림이 울리는 순간이 이미 배상이 발생한 순간이 된다.
네 개념을 한 번에 정리하면 이렇다.
| 개념 | 무엇인가 | 누구와의 약속 | 어겼을 때 |
|---|---|---|---|
| SLI | 실제로 관측한 값 | — (측정) | 해당 없음 |
| SLO | 내부적으로 합의한 목표 | 팀 사이의 합의 | 배포 동결 등 내부 정책 발동 |
| Error Budget | 목표와 100% 사이의 여유분 | 팀 사이의 합의 | 소진 시 정책 발동 |
| SLA | 고객과 맺은 계약 | 외부 고객 | 요금 크레딧 등 금전적 배상 |
대부분의 조직에서 매일 들여다보는 것은 위의 세 줄이다. SLA는 그 세 줄이 제대로 돌아갈 때 자연히 지켜지는 결과에 가깝다.
5. 인프라 팀이 지표로 서비스를 운영해야 하는 이유
앞서 이야기했던 서비스 레벨에 대한 다양한 지표들과 에러 예산을 고려해 보면, 조직 내에서 인프라 팀이 할 수 있는 것들이 정해진다. SLO를 어떻게 설정하느냐에 따라서 인프라 조직이 수행해야 하는 일들이 정해지는 것이다.
5.1 판단을 사람에서 규칙으로 옮긴다
장애가 발생했을 때 빠르게 대응해야 하는 것은 누구나 알고 있는 사실이다. 그리고 예를 들어 MSA 구조에서 결제 서버와 상대적으로 덜 치명적인 백오피스 서버에 동시에 장애가 발생했다면, 어떤 서버를 먼저 대응해야 하는지는 누구나 직감적으로 알 수 있을 것이다.
다만 이런 직감이 아니라 SLO를 기준으로 설명하게 된다면, 결제 서버와 백오피스 서버가 각각 어느 정도의 가용성을 보장해야 하며, 남은 에러 예산이 어느 정도이고, 어느 정도의 다운타임을 허용하는지를 측정할 수 있게 된다.
직감이 문제가 되는 것은 서비스가 두 개일 때가 아니라 서른 개가 될 때다. 결제와 백오피스라면 누구나 우선순위를 안다. 그런데 알림이 동시에 다섯 개 울리고, 그중 셋은 이름만 봐서는 중요도를 알 수 없는 내부 서비스이고, 당직자가 그 서비스를 만든 사람이 아니라면 직감은 작동하지 않는다. SLO는 그 판단을 문서로 옮겨서, 누가 당직이든 같은 결론에 도달하게 만든다.
5.2 신뢰성을 ‘요구사항’으로 만든다
인프라 팀이 자주 겪는 상황이 있다. 이중화가 필요하다고 말하지만 다음 분기 로드맵에서 밀린다. 신뢰성 작업은 눈에 보이는 산출물이 없고, 기능은 있기 때문이다.
문제는 논리보다 언어에 있다. “이 구성은 위험하다"는 문장은 우선순위 경쟁에서 이기기 어렵다. 반면 이런 문장은 성격이 다르다.
결제 API의 SLO는 99.9%이고, 지난 두 분기 연속 에러 예산을 초과했다. 정책에 따라 이번 분기에는 신규 기능 배포가 동결된다.
같은 주장이 합의된 요구사항으로 바뀐다. 신뢰성 작업이 인프라 팀의 희망사항에서 정책상 해야 하는 일이 되는 순간이다.
프로비저닝 규모를 정할 때도 같은 구조가 작동한다. 도입부에서 얼마를 준비해야 충분한가라는 질문을 꺼냈는데, 이 질문에는 그 자체로 답이 없다. 목표 가용성이 정해지고 나서야 필요한 이중화 수준, 리전 구성, 여유 용량이 계산 가능한 값이 된다. 인프라 팀에게 SLO가 필요한 가장 실무적인 이유가 이것이다. 얼마나 준비할지는 얼마까지 실패를 허용할지에서 따라 나온다.
5.3 알림이 의미를 되찾는다
알림이 많아지면 알림을 믿지 않게 된다. 새벽에 울린 알림 열 개 중 아홉 개가 아무 조치도 필요하지 않았다면, 열 번째도 같은 취급을 받는다.
이 문제의 원인은 대개 알림이 원인에 걸려 있다는 점이다. CPU 80%, 디스크 사용률 90%, 메모리 임계값 — 모두 셀 수 있고 임계값을 정하기도 쉽지만, 사용자가 지금 불편한지와는 직접 연결되지 않는다. CPU가 80%여도 응답시간이 정상이라면 사용자에게는 아무 일도 일어나지 않은 것이다.
SLO 기반 알림은 반대 방향에서 접근한다. 사용자 영향이 있을 때만 울린다. 그리고 2.4에서 본 burn rate가 여기서 강도까지 정해준다. 예산을 빠르게 태우는 중이면 호출이고, 천천히 새는 중이면 티켓이다.
여기서 얻는 것은 알림 개수가 줄어드는 것 자체가 아니다. 남은 알림을 신뢰하게 되는 것이다. 울렸다면 실제로 사용자가 겪고 있다는 뜻이므로, 새벽에 일어날 이유가 생긴다.
5.4 시작하는 방법
완벽한 SLO 체계를 먼저 설계하려 하면 시작하지 못한다. 모든 서비스에 지표를 붙이고 전사 합의를 받는 일은 몇 분기가 걸리는 프로젝트이고, 대개 중간에 멈춘다.
현실적인 순서는 이렇다.
- 사용자 여정 하나를 고른다. 이 서비스에서 가장 중요한 흐름 하나면 된다. 결제, 로그인, 검색 중 하나.
- SLI 하나를 정의한다.
good과valid를 정하는 일이다. 여기에 시간을 써야 한다. - 목표 없이 먼저 관측한다. 몇 주간 그냥 측정한다. 현재 수준을 모르는 상태에서 정한 목표는 대개 틀린다.
- 관측값을 근거로 SLO를 정한다. 현재 수준보다 약간 낮게 시작하는 편이 좋다. 달성 불가능한 목표는 정책 자체를 무력화한다.
- 에러 예산 정책을 합의한다. 2.3의 네 항목이면 충분하다. 문서 한 장으로 시작한다.
- 분기마다 다시 본다. 예산이 매번 남으면 목표를 올리고, 매번 터지면 목표가 현실과 맞지 않거나 신뢰성 작업이 부족한 것이다.
구글 SRE 워크북에는 이 과정에 바로 쓸 수 있는 예시 문서가 부록으로 붙어 있다. Appendix A가 SLO 문서의 예시이고, Appendix B가 에러 예산 정책의 예시다. 처음 만들 때 빈 페이지에서 시작하지 않아도 된다.
마치며
이 글은 얼마를 준비해야 충분한가라는 질문에서 시작했다. 글을 쓰면서 확인한 것은 그 질문이 단독으로는 답이 없는 질문이었다는 사실이다. 얼마까지 실패를 허용할지 정하지 않으면 얼마를 준비해야 하는지도 정할 수 없다. SLO는 그 순서를 바로잡는 장치였다.
세 개념을 다시 정리하면 이렇게 읽힌다. SLI는 무엇을 볼지 정하는 일이고, SLO는 어디까지가 괜찮은지 합의하는 일이고, 에러 예산은 그 합의를 매일의 의사결정에 연결하는 일이다. 그래서 이것들은 측정 도구가 아니라 실패를 미리 합의해 두는 방식에 가깝다. 장애가 터진 다음에 무엇을 할지 정하는 조직과 터지기 전에 정해둔 조직의 차이는 대응 속도가 아니라 대응의 일관성에서 나온다.
100%를 목표로 삼지 않는 것이 태만처럼 느껴질 수도 있다. 하지만 1.2의 곱셈 구조를 한 번 보고 나면 생각이 바뀐다. 100%는 야심이 큰 목표가 아니라 애초에 도달할 수 없는 좌표이고, 그것을 목표로 선언하는 순간 조직은 실패를 다룰 언어를 잃는다. 실패의 총량을 미리 정해두는 쪽이 훨씬 공학적인 태도다.
처음에 이 개념들을 찾아봤을 때 아쉬웠던 것은 정의가 어려웠기 때문이 아니다. SLO가 무엇인지는 한 줄로 읽을 수 있었다. 부족했던 것은 그 정의가 왜 필요했는지였다. 100%가 불가능하다는 사실에서 출발해 에러 예산까지 따라가 보면 세 개념이 각자 존재하는 이유가 생긴다. 정의를 외우는 것과 그 정의가 필요했던 맥락을 아는 것의 차이가, 이 글을 쓰면서 가장 크게 남은 부분이다.
References
구글 SRE 3부작
세 권 모두 전문이 무료로 공개되어 있다. (sre.google/books)
| 책 | 원문 |
|---|---|
| Site Reliability Engineering (2016) | 목차 |
| The Site Reliability Workbook (2018) | 목차 |
| Building Secure & Reliable Systems (2020) | 목차 |
이 글에서 직접 참고한 장
| 출처 | 장 |
|---|---|
| SRE Book | 3장 Embracing Risk |
| SRE Book | 4장 Service Level Objectives |
| SRE Book | 6장 Monitoring Distributed Systems |
| SRE Book | 10장 Practical Alerting |
| Workbook | 1장 How SRE Relates to DevOps |
| Workbook | 2장 Implementing SLOs |
| Workbook | 3장 SLO Engineering Case Studies |
| Workbook | 5장 Alerting on SLOs |
| Workbook | 16장 Canarying Releases |
| Workbook | Appendix A. Example SLO Document |
| Workbook | Appendix B. Example Error Budget Policy |
데이터 출처
- GitHub Status — 1.1의 컴포넌트별 90일 uptime. 2026년 8월 21일 조회 기준이며, 90일 롤링 윈도우이므로 현재 값은 다르다.